개인공부/자료구조
[자료구조] 우선순위 큐
개바리여리
2025. 5. 30. 12:33
각 요소에 우선순위가 부여된 큐이다.
“중요한 걸 먼저 처리”할 수 있는 빠른 정렬 큐
일반큐는 FIFO 구조이지만 , 우선순위 큐는 우선순위가 높은 요소가 먼저 나간다.
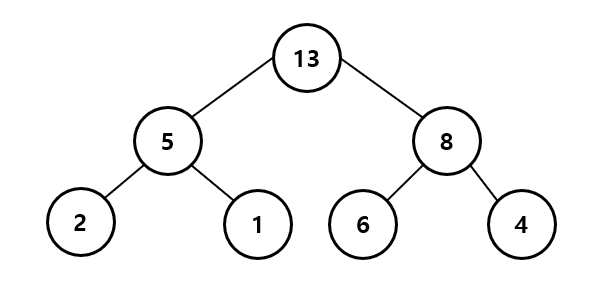
주요 특징
- enqueue : 큐에 데이터를 삽입
- dequeue : 큐에 데이터를 꺼냄
우선순위 큐는 힙 , 배열/연결리스트 기반 구현 방식들이 있는데 대표적으로는 힙 방식이 가장 일반적이다.
배열로 할 경우에는 우선순위가 높을수록 낮은인덱스에 위치해야 하는데 삽입.삭제가 일어나면 데이터들을 재정렬해줘야 한다.
또한 삽입위치를 찾기위해 탐색을 해야한다. --> 비효율적
연결리스트 또한 여전히 삽입 위치를 탐색해야 하는 비효율성이 존재한다.
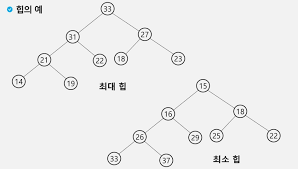
힙은 완전 이진 트리 구조이고 모든 노드에 저장된 값은 자식노드에 저장된 값보다 크거나(최대힙)
작아야 한다. (최소 힙)
최대힙이면 루트노드가 가장 크고 최소힙이면 루트노드가 가장 적다.
루트 노드에 가장 우선순위가 높은 데이터를 정렬할 수 있기에 우선순위 큐로 적합하다.
힙의 데이터 저장
추고하려는 데이터를 트리의 단말 노드에 빈 공간에 추가한 뒤 이후에 부모 노드와 비교를 통하여 우선순위를 판별한다.
부모모다 우선순위가 높다면 스왑이 일어나게 된다.
힙의 데이터 삭제
우선순위가 높은 루트노드를 삭제한뒤에 단말노드 중 가장 오른쪽에 위치한 노드를 루트로 위치시켜 자식 노드와 우선 순위
비교를 하며 위치를 조정해간다.
우선순위 큐의 장점
| 우선순위 처리 | 단순 FIFO가 아닌, 중요한 작업을 먼저 처리 가능 |
| 효율적인 정렬 | O(log n) 시간에 정렬된 상태 유지 |
| 힙 구조 덕분에 빠름 | 항상 루트에 가장 중요한 요소가 위치함 |
| 실시간 처리에 적합 | 알고리즘, 네트워크 패킷, 스케줄러 등에 유용 |
단점
| 임의 삭제/탐색 느림 | 특정 요소를 찾거나 삭제하면 O(n) 걸림 (힙은 인덱스 접근 불가) |
| 정렬 순서 접근 어려움 | 전체 요소를 정렬된 순서로 꺼내려면 반복 poll() 필요 |
| 메모리 사용 증가 가능 | 내부 구조 유지(힙 등)를 위한 추가 연산 및 저장공간 사용 |
시간 복잡도
최악일때는 트리의 높이만큼 비교 연산이 일어나기 때문에
| insert (삽입) | O(log n) | 힙 구조 유지하면서 삽입 |
| poll (최고 우선순위 제거) | O(log n) | 루트 제거 후 재정렬 |
| peek (최고 우선순위 조회) | O(1) | 루트 노드 바로 반환 |
| contains, 임의 삭제 | O(n) | 특정 값 탐색은 전체 탐색 필요 |
| 전체 꺼내며 정렬 | O(n log n) | poll n번 수행 = 정렬과 같음 |