[DataBase] 인덱스란?
인덱스
RDBMS 에서 테이블을 효율적으로 탐색 및 관리를 가능케 하는 색인 같은 개념이다.
대표적인 비유로 책의 목차라고 볼 수 있다.
목차가 없다면 우리는 원하는 주제를 얻기 위해 책을 모두 뒤져야 한다.(풀스캔)
하지만 목차가 있기 때문에 우리는 목차를 보고 페이지를 바로 찾아 갈 수 있다.
인덱스도 같은 개념이다.
* 조건을 만족하는 튜플을 빠르게 조회하기 위해서 ! 빠르게 정렬하거나 그룹핑하기 위해 사용된다.
인덱스에 대한 부가정보 : https://develop-actas.tistory.com/74
인덱스
대용량 데이터를 다루는 현대의 데이터베이스 시스템에서 성능은 곧 생산성과 직결됩니다. 수천, 수만 건의 데이터를 대상으로 검색, 정렬, 조인 같은 연산을 빠르게 처리하기 위해서는 단순한
develop-actas.tistory.com
B-Tree 기반의 인덱스는 다음과 같이 구성되어 있습니다.
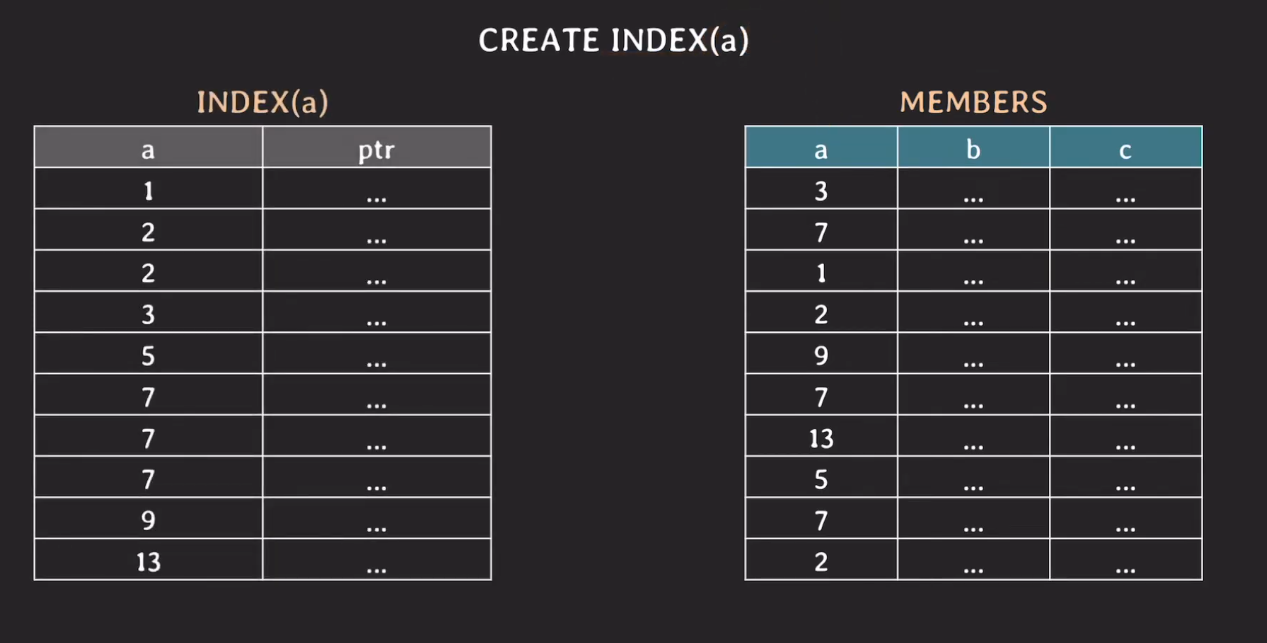
인덱스가 생성되면 테이블 형태로 (b트리기반) 디스크 공간을 차지해서 만들어진다.
왼쪽과 같이 a를 기준으로 인덱스가 생성되어 정렬되어 있는 형태로 만들어지고 탐색시에 해당 a값이 가지는 포인터(실제 테이블에서 해당 데이터의 위치)를 찾아 테이블로 이동하게 된다.
탐색시에는 바이너리 서치를 이용하여 a = 9 인 값을 찾을때는 a=5 를 기준으로 이전 값들은 건너뛰고 다시 7를 기준으로 작은 값들은 건너 뛰는 형식을 반복함으로서 a=9인 값을 찾을때 까지 반복한다.
근데 만약 조건이 a = 7 and b = 95 인 값을 찾으려 할때는 인덱스에는 b 값에 대한 정보는 없기때문에 a가 7인 정보들을 인덱스에서 탐색하게 될 것이다. 인덱스에서 a가 7인 튜플들을 찾아서 탐색하게 된다. (인덱스에서 확인후 테이블에서 b값이 맞는지 비교)
결국에는 a = 7이라는 데이터에 대해서 풀스캔이 일어나게 된다.
이런것을 위해 a,b를 묶어서 인덱스 생성도 가능하다. (a를 기준으로 먼저 정렬후 같은 a값에 대하여 b에 대해 정렬한다.)
인덱스에는 a와b에 정보가 모두 있기 때문에 풀스캔이 안일어나고 바로 테이블에서 찾아 반환이 가능해진다.
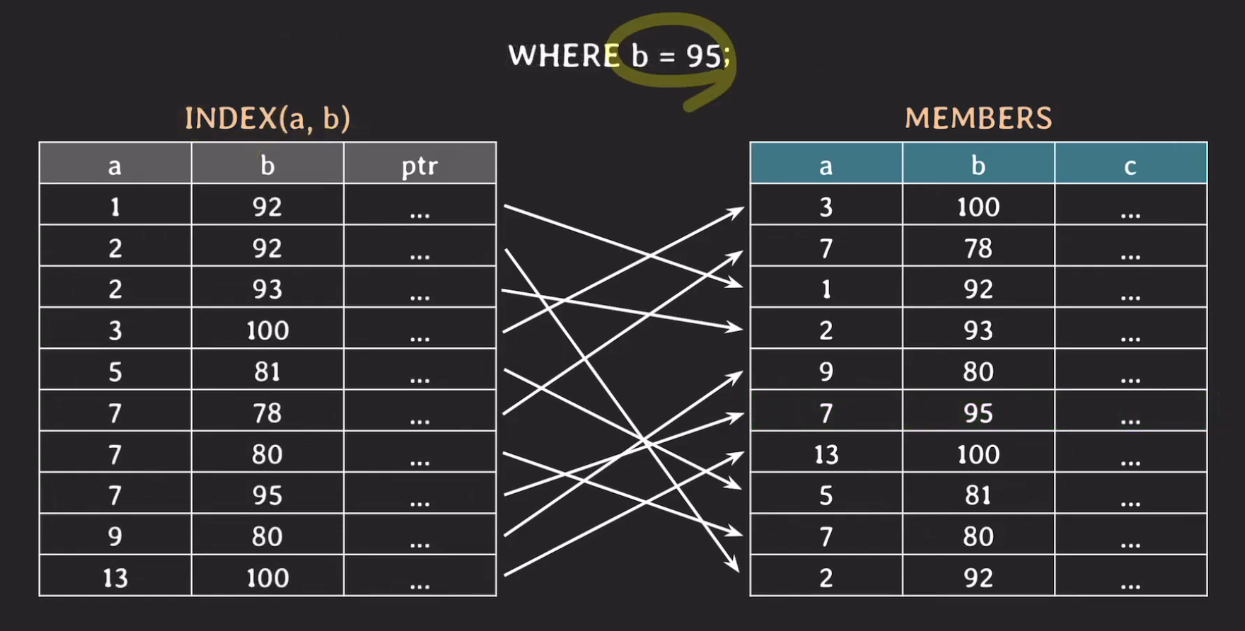
복합 인덱스에서 b가 95인 데이터만을 찾으려할때는 인덱스가 성능 발휘를 하지 못한다. 1차적으로 a를 기준으로 먼저
정렬을 했기 때문에 결국에는 b가 95인 데이터를 찾기위해 풀스캔이 일어나게 된다.
그래서 인덱스 사용시에는 순서가 중요해지는 것이다.
select * from test where id = 10;
이러한 쿼리에서 만약 테이블에 인덱스에 여러개 걸려있다면 어떤 인덱스를 선택하느냐? --->
db 옵티마이저가 실행계획을 세워 비용이 가장 저렴하다고 생각하는 것을 실행하게 된다.
하지만 개발자가 직접 인덱스를 강제 할 수도 있다.
select * from test use index (id_idx) where id = 7;  -- id_idx 라는 인덱스를 사용하라고 권장
select * from test force index (id_idx) where id = 7;  -- id_idx 라는 인덱스를 사용하라고 강요
이렇게 search 시에는 인덱스가 엄청 유용하지만 단점도 존재한다.
바로 삭제 및 추가 수정 시에 일어나게 된다.
데이터에 대한 변화로 인해 인덱스도 다시 데이터를 정렬하고 배치해야 하기 때문이다.
Covering Index
데이터베이스에서 쿼리를 처리할 때 필요한 모든 컬럼이 인덱스에 포함되어 있어서 테이블을 조회할 필요가 없는 인덱스
즉 색인에서 모든 정보를 가지기 때문에 굳이 테이블로 가서 튜플을 직접 뽑아올 필요가 없다. --> 매우 빠른 search 가능
Hash index
해시 인덱스는 값을 특정한 해시 함수로 변환하여, 그 결과값을 키로 사용하는 자료구조
- 찾고자 하는 값을 해시로 "변환"해서
- 그 위치를 배열처럼 바로 찾아가는 구조
- name = '홍길동' 이라는 값을 넣으면
- → 해시 함수가 "000A"로 매핑
- → 000A 버킷에서 직접 찾아감 → row ID 찾음 → 결과 반환
B+ Tree처럼 단계별로 내려가는 탐색 없음! → O(1) 수준의 빠른 접근 가능
아주 빠른 검색이 가능하지만 동등비교(=)만 가능하다. 해시값으로 찾는 것이기 때문에 당연한 것...
범위 탐색은 불가능하고 정렬도 될 수 없다.
**** 인덱스를 이용한 탐색시 사용되는 탐색 종류
주요 Seek/Scan 종류 요약
| Clustered Index Seek | 클러스터 인덱스를 통해 정확한 위치 조회 | 빠름 |
| Clustered Index Scan | 클러스터 인덱스를 처음부터 끝까지 읽음 | 느림 |
| Non-Clustered Index Seek | 보조 인덱스에서 원하는 값만 찾아 읽음 | 빠름 |
| Non-Clustered Index Scan | 보조 인덱스를 전부 순회 | 느림 |
| Key Lookup (RID Lookup) | 보조 인덱스 찾은 후, 실제 데이터 다시 조회 | Seek + Random Access 성격 |
| Table Scan | 인덱스 없이 테이블 전체 순회 | 매우 느림 (가장 비효율적) |
클러스터 인덱스 --> 테이블 자체가 인덱스로 정렬된 구조이다. (보통 PK를 걸면 클러스터 인덱스가 적용된다.)
키 룩업에 경우네는 보조인덱스에 원하는 정보가 없기 때문에 본 테이블에서 정보를 가져오려고 실제 데이터를 다시 조회하게 된다.
글의 전반적인 내용은 유튜버 '쉬운코드' 님의 강의 내용을 참고하였습니다.