[JAVA] Call By Value & Call By Reference
Call By Value
값에 의한 호출이라고도 부르며 값을 복사하여 처리한다.
변수의 복사본이 전달되며 원래 원시값을 변경하지 않는다.
public static void main(String[] args) {
    int x = 10;
    changeValue(x);
    System.out.println(x); // 출력: 10 (안 바뀜)
}

static void changeValue(int n) {
    n = 20; // 지역 변수 n만 변경됨
}
Call By Reference
값의 주소를 참조하여 전달한다.
변수 자체가 그대로 전달되며 원시값에 영향을 끼칠 수 있다.
void changeValue(int &n) { // 참조 전달
    n = 20;
}

int main() {
    int x = 10;
    changeValue(x);
    cout << x; // 출력: 20 (값 바뀜)
}
자바에서의 데이터타입은 기본타입 (int, double 등) 과 참조 타입 (객체, 배열 등) 이 존재한다.
- 기본형 (int, double 등)
→ 값이 복사되어 전달. 함수 안에서 수정해도 원본은 안 바뀜. - 참조형 (객체, 배열 등)
→ 참조(주소)의 값이 복사되어 전달. 즉, 원본 객체를 가리키는 *참조값(주소)*을 복사해서 넘김.
따라서 함수 안에서 객체 내부 필드를 수정하면 원본에도 반영됨.
하지만 함수 안에서 참조 자체를 새 객체로 바꾸면 원본에는 영향 없음.
void primitivie(){
	int v = 10;
    add(v);
    System.out.println(v) //10 안바뀜
}

void add(int num){
	num++;
}
add메서드의 인자로 num은 기본타입이므로 값인 1 자체가 전달되고 primitivie메서드의 v 변수랑 관련이 없는 값이 num
으로 전달되는것이다. (값 자체인 1 을 전달)
* primitive 호출시
[Stack]
┌──────────────────────────────┐
│ primitive() Stack Frame      │
│   v = 10                     │
└──────────────────────────────┘

[Heap]
(아직 사용 안 함 — int는 기본형이므로 Heap에 안 올라감)
* add 호출
[Stack]
┌──────────────────────────────┐
│ add() Stack Frame            │
│   num = 10   ← v의 값 복사   │
└──────────────────────────────┘
┌──────────────────────────────┐
│ primitive() Stack Frame      │
│   v = 10                     │
└──────────────────────────────┘

[Heap]
(여전히 없음)
* num++ 실행
[Stack]
┌──────────────────────────────┐
│ add() Stack Frame            │
│   num = 11   (지역 변수만 변경) │
└──────────────────────────────┘
┌──────────────────────────────┐
│ primitive() Stack Frame      │
│   v = 10                     │
└──────────────────────────────┘
* add() 종료
[Stack]
┌──────────────────────────────┐
│ primitive() Stack Frame      │
│   v = 10                     │
└──────────────────────────────┘

[Heap]
(여전히 없음)
* 참조형이 매개변수로 넘어가는 경우
class Person {
    String name;
}

public class Main {
    public static void main(String[] args) {
        Person p = new Person();
        p.name = "Alice";

        changeName(p);
        System.out.println(p.name); // 출력: Bob (객체 내부 값은 바뀜)

        reassign(p);
        System.out.println(p.name); // 출력: Bob (참조를 새로 할당해도 원본엔 영향 없음)
    }

    static void changeName(Person person) {
        person.name = "Bob"; // 참조된 객체 내부 값 변경 → 원본도 변경됨
    }

    static void reassign(Person person) {
        person = new Person(); // 참조 자체만 새로 바뀜 → main의 p는 영향 없음
        person.name = "Charlie";
    }
}
이것을 봤을때 changeName 메서드를 통해 값이 변경되었으니 자바는 CallByReference 아닌가?
라고 생각할 수 있지만 reassing 메서드를 보면 객체를 재할당 하면 값이 바뀌지 않는다.
기존 복사된 참조주소를 지우고 다른 주소로 갈아끼웠기 때문이다. (즉, 참조객체의 주소값을 복사했기 때문.)
그런데 새로운 객체로 대입하면 값은 안바뀌므로 CallByValue 이다.
만약 CallByReferencd 였다면 p 자체가 새 객체를 가리키게 되었을 것임
++ 여기서 Call by Reference였으면
원래 person가 새 객체로 바뀌어야 함.
하지만 Java는 그게 안됨.
reassign의 지역 변수 person만 새로운 객체를 가리킬 뿐, 원본 person 는 그대로.
main()
changeName(person)
person에 p의 “참조값(주소)”이 복사됨:
그래서:
이렇게 하면 같은 객체(Person #1) 의 name이 바뀜.
즉,
- 변수는 다른 것 (p ≠ person)
- 하지만 둘 다 같은 객체(힙 메모리 객체)를 바라봄
따라서 내부 값은 바뀐다.
결론:
Java는 참조값(객체의 주소)을 '값(Value)'으로 복사해서 넘기기 때문에,
복사된 참조로 같은 객체를 가리키므로 객체 내부는 바뀐다.
- 참조(주소) 자체는 복사본이라 바꿔도 원본 변수는 안 바뀜
- 하지만 그 참조가 가리키는 실제 객체는 공유됨
그래서 객체 내부 값은 바뀌지만 객체 자체를 교체하면 원본은 안 바뀐다.
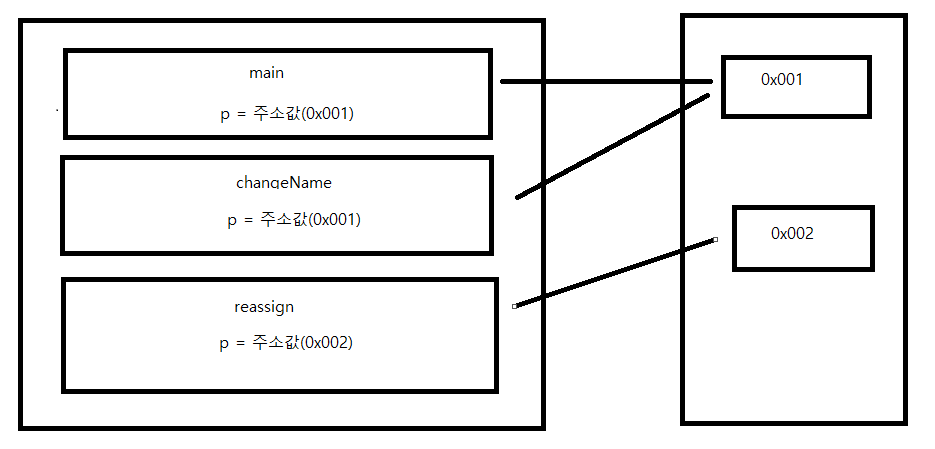
이런 형식으로 나오게 된다.
보면 reassign은 아예 다른 주소를 가르켜서 기존 Person 객체와 무관해짐 --> 주소값을 복사해서 넘겼기때문.
***** 참조값 자체를 넘겼다면 기존 Person 객체도 0x002를 가르켜야함.
+++++ 개인적인 공부용도인 String의 특징
1. 불변성
String 객체는 한 번 생성되면 내부 값(char[])이 절대 바뀌지 않음.
문자열이 바뀐 것 처럼 보이지만, 실제로운 새로운 String 객체를 생성한 것 뿐이다.
생성한 객체는 문자열 상수 풀에 넣어서 나중에 재사용한다.
String s= " Hello ";
s = s + "World"; // Hello World 라는 새로운 객체로 바뀐것.
- "Hello" 객체는 여전히 Pool에 존재 (불변이므로 그대로 유지).
- "Hello World"라는 새 객체가 Heap에 만들어지고, s가 그걸 가리킴.
- 즉, 기존 "Hello"는 안 바뀌고 새 객체가 생성됨.
2. 문자열 상수 풀 (String Constant Pool)
일한 문자열 리터럴은 String Pool에 저장됨.
같은 값의 문자열 리터럴을 만들면 새 객체를 생성하지 않고 Pool의 객체를 재사용. (자원 재활용 및 캐싱)
String a = "Java";
String b = "Java";
System.out.println(a == b); // true (같은 객체 참조)
하지만 new String("Java")는 무조건 Heap에 새로운 객체를 생성함.
String a = "Java";
String b = new String("Java");
System.out.println(a == b); // false
이렇게 불변성을 가짐으로써 여러쓰레드가 동시에 접근해도 안전한 Thread-Safe 한 구조를 가지게 된다.
또한 비밀번호같은 보안이 중요한 정보들을 중간에서 변경 불가능.
변경이 많다면 StringBuilder나 StringBuffer가 권장됩니다.
이 클래스들은 mutable(변할 수 있는) 객체로, 내부 버퍼를 이용해 문자열을 효율적으로 수정하고 추가할 수 있어 불필요한 객체 생성을 막아줍니다.
- 리터럴로 생성하는 경우 (String str = "hello";)
- 이 방식은 **String 상수 풀(String Constant Pool)**이라는 특별한 메모리 영역을 사용합니다.
- 자바 가상 머신(JVM)은 먼저 상수 풀에 "hello"라는 문자열이 있는지 확인합니다.
- 만약 있다면, 새로 생성하지 않고 기존 객체의 참조를 반환합니다.
- 만약 없다면, 새로운 String 객체를 상수 풀에 생성하고 그 참조를 반환합니다.
- 따라서 String str1 = "hello"; 와 String str2 = "hello";는 동일한 객체를 참조하게 됩니다. 이 경우는 메모리 낭비가 거의 없습니다.
- new 키워드로 생성하는 경우 (String str = new String("hello");)
- 이 방식은 힙(Heap) 메모리 영역에 새로운 String 객체를 만듭니다.
- 상수 풀에 "hello"가 이미 존재하더라도, new 키워드를 사용하면 무조건 새로운 객체가 생성됩니다.
- 이때 상수 풀에는 "hello" 리터럴이, 힙에는 새로운 "hello" 객체가 생성되어 두 개의 객체가 존재하게 됩니다.
- 이렇게 반복해서 new String()을 사용하면 힙에 불필요한 객체들이 계속 쌓여 메모리 낭비를 초래할 수 있습니다.
String 객체는 한 번 생성되면 내용이 변하지 않는 불변(immutable) 객체입니다. 따라서 문자열을 변경하는 연산(예: + 연산)을 수행하면 기존 객체를 수정하는 것이 아니라, 새로운 String 객체를 만듭니다.
String str = "hello";
str = str + " world";
str + " world" 연산은 "hello" 객체와 " world" 객체를 합쳐서 새로운 "hello world" 객체를 힙에 생성합니다. 이처럼 문자열을 계속해서 더하는 연산을 반복하면 메모리 낭비가 심해질 수 있습니다.
3. 불변성을 띄므로 보안성이나 Thread-Safe한 구조를 가지게 된다.
값이 변경되지 않고 새로운 값을 또 만들어버리기 때문에 여러 스레드가 동시에 같은 문자열을 참조해도 안전하다.
또한 값이 불변이라서 중간에 참조하는 메모리 주소 값이 위조되거나 변경될 일이 없다.
4. String vs StringBuilder vs StringBuffer
- String: 불변 → 문자열을 자주 수정하면 비효율적(새 객체 계속 생성).
- StringBuilder: 가변(Mutable), 동기화 X → 단일 스레드 환경에서 성능 좋음.
- StringBuffer: 가변(Mutable), 동기화 O → 멀티 스레드 환경에서 안전.
StringBuilder sb = new StringBuilder("Hello");
sb.append(" World");
System.out.println(sb); // Hello World (객체 그대로 수정됨)
| 타입 | 변경가능성 | 스레드안전 | 주 사용처 | 성능 |
| String | 불변(immutable) | 불변이라 안전 | 상수/키/로그 라인 등 변경 거의 없음 | 변경할 때마다 새 객체 생성 → 잦은 연결엔 비효율 |
| StringBuilder | 가변 | (동기화 없음) | 단일 스레드에서 많이 합치기 | 가장 빠름. append가 O(1) amortized |
| StringBuffer | 가변 | (모든 메서드 동기화) | 여러 스레드가 한 인스턴스를 함께 편집 | StringBuilder보다 느림(동기화 오버헤드) |
가변 버퍼 StringBuilder – 연결이 많을 때의 표준해답
- 내부에 가변 배열을 두고 끝에 덧붙이는 방식.
- 잦은 append에도 한 인스턴스 안에서 처리 → GC/복사 비용 최소화.
StringBuilder sb = new StringBuilder(64); // 예상 길이를 주면 리사이즈 적음
sb.append("Hello");
sb.append(" World");
String s = sb.toString();
동기화된 StringBuffer – 멀티스레드에서 정말 필요할 때만
- 모든 메서드가 synchronized → 여러 스레드가 ‘같은 인스턴스’를 동시에 append할 때 안전.
- 하지만 요즘은 보통
- 스레드마다 자기 빌더를 따로 쓰거나
- 바깥에서 락으로 보호하는 쪽을 선호 → 그래서 StringBuilder가 더 자주 쓰임.
// 여러 스레드가 반드시 '같은' 버퍼에 안전하게 쓸 필요가 있을 때만
StringBuffer safe = new StringBuffer();
safe.append("A");
StringBuffer는 각 메서드별로 Synchrozied 키워드가 존재한다.
느려지는 대표 함정: 루프에서 +=
String s = "";
for (String part : parts) {
    s += part;   //  매 반복마다 새 StringBuilder 생성 + 새 String 객체 복사
}
아래처럼 고치는것이 권장됩니다.
StringBuilder sb = new StringBuilder(totalExpectedLength); // 가능하면 길이 예측
for (String part : parts) {
    sb.append(part);
}
String s = sb.toString();
*** JDK1.5 버전 이후에는 컴파일 단계에서 String 객체를 사용하더라도 StringBuilder로 컴파일 되도록 변경되었습니다.
하지만 반복문에서 문자열을 더 할때 객체를 계속 추가한다는 것은 변하지 않습니다.
String s1 = "hello";
        String s2 = "hello";

        System.out.println(s1 == s2);
        System.out.println(s1.equals(s2));
두 결과 모두 true가 나오는데 동등연산인 == 에서도 String인데 true가 나오는것은 상수풀에서 재사용되었기 때문이다.
같은 리터럴을 사용했기때문에 객체 참조를 공유한것임.
만약 String s3 = new String("hello"); 로 하게 된다면 == 결과가 false가 나옴.
* equals메서드는 Object의 메서드인데 기본적으로는 주소(참조값)을 비교한다.
String은 오버라이드로 재정의 되어있어서 내부의 char[] 값을 한 글자씩 비교하도록 구현되어 있다.
- equals()와 hashCode()의 관계
자바의 모든 객체는 Object 클래스를 상속받는다. 기본적으로 equals() , hashCode()를 가지고 있음.
여러 컬렉션에서 객체 비교시에 두 단계를 거치기 때문에 기본적으로 세트로 동작해야 합니다.
hashCode를 통해 객체가 들어갈 위치를 계산하고 equals를 통해 실제 내용이 같은지를 비교합니다.
@Override
public boolean equals(Object anObject) {
    if (this == anObject) return true;
    if (anObject instanceof String) {
        String anotherString = (String) anObject;
        int n = value.length;
        if (n == anotherString.value.length) {
            char v1[] = value;
            char v2[] = anotherString.value;
            int i = 0;
            while (n-- != 0) {
                if (v1[i] != v2[i]) //char인 기본형이므로 주소값이 아닌 기본값(유니코드)을 비교
                    return false;
                i++;
            }
            return true;
        }
    }
    return false;
}

@Override
public int hashCode() {
    int h = hash;
    if (h == 0 && value.length > 0) {
        char val[] = value;
        for (int i = 0; i < value.length; i++) {
            h = 31 * h + val[i];
        }
        hash = h;
    }
    return h;
}
hashCode는 31을 곱하면서 문자의 순서를 고려하기 때문에
"ABC"와 "ACB"는 hashCode가 달라집니다.
즉, “내용이 같으면 hashCode도 반드시 같다”
"A".hashCode() → 65
"AB".hashCode() → 2081
"ABC".hashCode() → 64514
A는 유니코드값으로 변환되어 65가 된다.
31을 곱하는 이유는 그냥 해시 충돌을 줄이는 적당한 값을 선정해서 곱한것.
또한 만약 곱하기가 아닌 그냥 더하기 였다면
"AB" 와 "BA"는 65 + 66 = 131 로 같다고 나와버림.
hashCode(객체내용을 숫자로 요약한 값)의 근본 목적은 “빠른 검색용 요약 숫자”이다. 단순 문자열 순서 비교용은 아님.
1️⃣ "apple".hashCode() 호출 → 숫자 하나 얻음 (예: 93029210)
2️⃣ 이 숫자를 버킷(bucket) 인덱스로 변환 (예: index = hash % tableSize)
3️⃣ 그 위치에 "apple" → 100 데이터를 저장
➡ 나중에 map.get("apple") 하면
→ "apple".hashCode() 다시 계산
→ 같은 버킷으로 바로 찾아감 (O(1) 시간에 접근)
equals와 hashCode의 관계
| equals()가 true면 hashCode도 같아야 한다 | 같은 객체를 서로 다른 버킷에 두면 안 되니까 |
| equals()가 false면 hashCode는 달라도 된다 | 다른 객체인데 같은 해시면 충돌(collison) 처리 가능 |
| hashCode()가 같다고 equals()도 true는 아님 | 해시 충돌이 있을 수 있음 |