[Spring] 비동기 프로그래밍
스프링 비동기 프로그래밍
특정 작업이 완료될때 까지를 기다리지 않고, 다음 코드를 직접 실행하는 방식이다.
웹 서비스에서 모든 작업을 요청-응답 흐름 안에서 동기적으로 처리한다면
처리 시간이 길어지고 서버 자원에 대한 낭비가 있어 응답성이 떨어질 수 있다.
스프링 비동기는 이러한 문제해결을 위해 작업을 별도의 스레드에 할당하고
매인 요청 스레드는 즉시 반환하도록 설계된 처리 방식이다.
JVM 내에서 비동기는 Main Thread가 아닌 쓰레드풀을 생성하여 Sub Thread 에 task를 위임하고
백그라운드에서 비동기 작업을 처리하게 된다.
여기서 말하는 메인 스레드는 하나가 아니다.
요청마다 JVM은 서버가 관리하는 스레드풀에서 스레드 하나를 할당받아
해당 스레드가 요청 처리와 응답 반환을 수행한다.
응답이 반환되면 해당 스레드는 종료되지 않고
다시 스레드풀로 반환되어 다음 요청을 처리하는 데 재사용된다.
따라서 메인 스레드란 고정된 하나의 스레드를 의미하는 것이 아니라,
“현재 요청을 처리 중인 스레드”를 지칭하는 개념적 표현이며
각 요청마다 메인 역할을 수행하는 스레드가 존재한다.
왜 비동기가 필요한가?
일반적인 동기 처리 구조에서는:
- DB 조회
- 외부 API 호출
- 파일 처리
- 메일 / 알림 전송
같은 시간이 오래 걸리는 작업이 끝날 때까지
요청 스레드가 블로킹(blocking)된다.
비동기 처리를 적용하면:
- 요청 스레드는 빠르게 반환
- 실제 작업은 백그라운드에서 수행
- 서버는 더 많은 요청을 동시에 처리 가능
즉, 처리량(Throughput)과 응답성(Response Time) 을 동시에 개선할 수 있다.
비동기 처리의 단점
- 트랜잭션 전파 문제
@Transactional 은 스레드에 바인딩된다.
즉, 트랜잭션은 “메서드 호출”이 아니라 “현재 실행 중인 스레드” 기준, @Async는 다른 스레드에서 실행된다.
@Transactional
public void order() {
    saveOrder();           // 트랜잭션 O
    asyncService.send();   // 비동기
}

@Async
public void send() {
    saveLog(); // ❌ 트랜잭션 없음
}
기존의 트랜잭션이 적용되지 않는다.
- 스레드 풀 고갈
스프링의 비동기는 무제한 스레드 생성이 아니다.
대부분 ThreadPoolTaskExecutor 를 사용한다.
corePoolSize, (해당 스레드풀에 최소한의 스레드를 몇개 가지고 있을것인지)
maxPoolSize (이 스레드풀에 최대 할당가능한 스레드 갯수),
keepAliveTime , (코어풀 사이즈보다 많이 할당되었을때 초과된 쓰레드들을 언젠가 반환해야 하는데
이 옵션의 시간만큼 유휴상태에 있다면 반납하겠다는 뜻)
queueCapa , (즉시 실행되지 못한 작업을 잠시 대기시키는 작업 큐의 크기)
등의 값을 초과하면 작업이 쌓이거나 거부된다.
- 예외 처리 누락
@Async
public void work() {
    throw new RuntimeException("에러");
}
비동기 메서드에서 발생한 예외는 호출한 쪽으로 전파되지 않는다.
비동기 작업에서의 처리 순서 :
1. corePoolSize 까지는 스레드를 생성한다. -> 즉시 실행 구조
2. corePoolSize를 초과하면 큐에 적재한다.
3. 큐가 가득차면 maxPoolSize 만큼 쓰레드를 확장한다.
4. maxPool + queueCapa 를 넘어버리면 작업이 거부된다.
Thread Pool 생성시 주의할 점
1. 코어풀 사이즈를 너무 크게 잡으면 리소스 낭비가 심해진다.
스레드 수 증가 -> 컨텍스트 스위칭 증가로 인해 cpu 캐시 효율 저하
2. queueCapacity는 “대기 시간”을 만든다.
너무 크면 작업이 오래 대기하게 되고 너무 작으면 스레드가 급격히 증가되며 리소스 압박이 이루어진다.
3. maxPoolSize는 최후의 수단이다.
maxPoolSize까지 도달했다는 것은 이미 시스템이 과부하 상태라는 신호다.
4. 비동기 작업에 대해 쓰레드풀을 구분해야 한다.
모든 비동기 작업을 하나의 스레드풀에서 처리하면 위험하다.
- I/O 작업 (API 호출, 메일, 파일)
- CPU 작업 (연산, 변환)
성격이 다른 작업은 스레드풀을 분리하는 것이 안전하다.
예시코드
AppConfig : Thread Pool 을 생성하기 위한 설정파일
@Configuration
public class AppConfig {

    @Bean(name = "defaultTaskExecutor", destroyMethod = "shutdown")
    public ThreadPoolTaskExecutor defaultTaskExecutor(){
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(200);
        executor.setMaxPoolSize(300);
        return executor;
     }

     @Bean(name = "messagingTaskExecutor", destroyMethod = "shutdown")
     public ThreadPoolTaskExecutor messagingTaskExecutor(){
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(200);
        executor.setMaxPoolSize(300);
        return executor;
     }

}
AsyncConfig : Async 를 사용하기 위해 설정하는 설정파일
@Configuration
@EnableAsync
public class AsyncConfig {


}
AsyncController : request 를 처리하고 응답을 반환할 컨트롤러
@RestController
@RequiredArgsConstructor
public class AsyncController {

    private final AsyncService service;

    @GetMapping("/1")
    public String async1(){
        service.asyncCall1();
        return "success";
    }

    @GetMapping("/2")
    public String async2(){
        service.asyncCall2();
        return "success";
    }

    @GetMapping("/3")
    public String async3(){
        service.asyncCall3();
        return "success";
    }

}
AsyncService
@Service
@RequiredArgsConstructor
public class AsyncService {

    private final EmailService emailService;

    public void asyncCall1(){
        System.out.println("asyncCall1 : " + Thread.currentThread().getName());
        emailService.sendMail();
        emailService.sendMail2();
    }

    public void asyncCall2(){
        System.out.println("asyncCall2 : " + Thread.currentThread().getName());
        EmailService emailService = new EmailService();
        emailService.sendMail();
        emailService.sendMail2();
    }

    public void asyncCall3(){
        System.out.println("asyncCall3 : " + Thread.currentThread().getName());
        sendMail();
    }

    @Async
    public void sendMail(){
        System.out.println("[내부 sendMail :] " + Thread.currentThread().getName());
    }

}
EmailService : 비동기 작업을 등록한 클래스
@Service
@RequiredArgsConstructor
public class EmailService {

    @Async("defaultTaskExecutor")
    public void sendMail(){
        System.out.println("sendMail : " + Thread.currentThread().getName());
    }
    @Async("messagingTaskExecutor")
    public void sendMail2(){
        System.out.println("sendMail2 : " + Thread.currentThread().getName());
    }
}
여기서 asyncCall1 에 대한 요청은 정상적으로 비동기 처리가 되는 것을 확인할 수 있다.
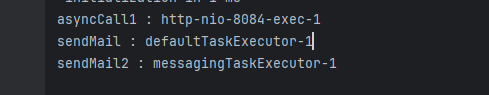
그림과 같이 모두 다른 쓰레드에서 담당하여 처리하는 것을 확인할 수 있다.
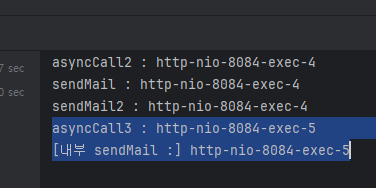
하지만 asyncCall2, asyncCall3 은 모두 같은 쓰레드가 처리하는 것을 확인 할 수 있다.
이유는 무엇일까? 왜 비동기 처리가 되지 않는걸까?
1. new 로 객체를 생성한 경우 (2번째 케이스)
객체를 new로 직접 생성하여 사용하면
스프링 컨테이너가 관리하는 EmailService 빈을 사용하는 것이 아니다.
@Async는 스프링이 관리하는 Bean에만 적용되며,
new로 생성한 객체에서는 절대 비동기로 동작하지 않는다.
이는 스프링이 Bean을 프록시 객체로 감싸서 관리하기 때문이며,
빈으로 한 번 등록된 객체여야만 @Async가 적용된
프록시 객체가 주입되어 비동기 처리가 가능해진다.
2. 자기 자신의 메서드를 호출 (3번째 케이스)
@Async는 프록시를 통해 호출될 때만 동작한다.
같은 클래스 내부에서 @Async가 붙은 메서드를 직접 호출하면
프록시를 거치지 않고 실제 객체의 메서드가 바로 실행되기 때문에
비동기로 실행되지 않는다.
이를 Self-invocation(자기 자신 호출) 문제라고 하며,
스프링 AOP 기반 기능에서 흔히 발생하는 주의사항이다.
Task 거부 될시 대응책
만약 corePool 만큼 쓰레드풀에서 이미 쓰레드가 동작중이며 작업큐에도 가득차고 MaxPoolSize 만큼도 늘렸는데도
작업을 받지 못해 거부되었을때 적절한 대처가 필요하다.
여기서 중요한 건 비동기 쓰레드는 Http 응답에 대한 반환권이 없다.
이미 요청에 대한 책임을 지는 메인쓰레드에 대해서 비동기작업 쓰레드는 분리되었기 때문에 직접적으로 해당 요청에 대해서
사용자한테 상태값을 반환할 수 없다는 것이다.
(웹소켓이나 SSE를 통해서 서버->클라이언트로 요청을 보내는 방식으로 사용자한테 알림은 줄 수 있다. 근데 이건
비동기랑 직접적인 관련이 아니므로 pass...)
1. RejectedExecutionHandler 사용
스레드가 가득 차서 reject 당할시 어떻게 처리할지 직접 정의한다. (로그로 남기기)
@Bean(name = "TestTaskExecutor", destroyMethod = "shutdown")
    public ThreadPoolTaskExecutor TestTaskExecutor(){
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(2);
        executor.setMaxPoolSize(3);
        executor.setQueueCapacity(1);

        executor.setRejectedExecutionHandler((r, e) -> {
            System.out.println("작업 거부됨!");
            System.out.println("ActiveCount: " + e.getActiveCount());
            System.out.println("QueueSize: " + e.getQueue().size());
        });

        return executor;
    }
테스트용 작업 스레드풀을 하나 만들어준다.
//서비스 부분
@Async("TestTaskExecutor")
    public void runTask(int i) {
        System.out.println(
                "▶ 실행 시작: " + i + " | " + Thread.currentThread().getName()
        );

        try {
            Thread.sleep(3000); // 일부러 오래 걸리게
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }

        System.out.println(
                "◀ 실행 종료: " + i + " | " + Thread.currentThread().getName()
        );
    }

    //컨트롤러 부분
    @GetMapping("/test/reject")
    public String testReject(){
        for (int i = 1; i <= 10; i++) {
            service.runTask(i);
        }
        return "요청 완료";
    }
실제로 호출해보면
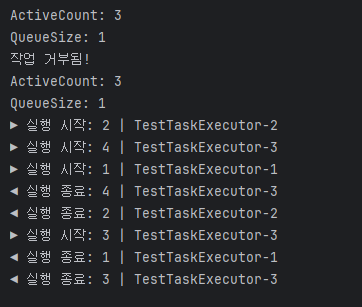
작업이 거부되며 실제 task가 소실되어 버린것을 알 수 있다.
그냥 로그 남기기용 인것이다.
2. CallerRunsPolicy (동기 강등)
스레드 풀이 가득차면 비동기 작업을 호출한 스레드가 직접 실행하게 한다.
//CallerRunsPolicy를 통해 거부될시 호출한 쓰레드에서 그냥 동기적으로 동작하게 하기
    @Bean(name = "TestTaskExecutor2", destroyMethod = "shutdown")
    public ThreadPoolTaskExecutor TestTaskExecutor2() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(2);
        executor.setMaxPoolSize(3);
        executor.setQueueCapacity(1);
        executor.setThreadNamePrefix("TestTaskExecutor-");

        //CallerRunsPolicy 적용
        executor.setRejectedExecutionHandler(
                new ThreadPoolExecutor.CallerRunsPolicy()
        );

        executor.initialize();
        return executor;
    }
이번에는 스레드풀을 위와 같이 만들어보자.
@Async("TestTaskExecutor2")
    public void runTask2(int i) {
        System.out.println(
                "▶ 실행 시작: " + i + " | " + Thread.currentThread().getName()
        );

        try {
            Thread.sleep(3000);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }

        System.out.println(
                "◀ 실행 종료: " + i + " | " + Thread.currentThread().getName()
        );
    }

    //////////////////////// 컨트롤러 부분
    @GetMapping("/test/caller")
    public String testCallerRuns() {
        for (int i = 1; i <= 10; i++) {
            service.runTask2(i);
        }
        return "요청 완료";
    }
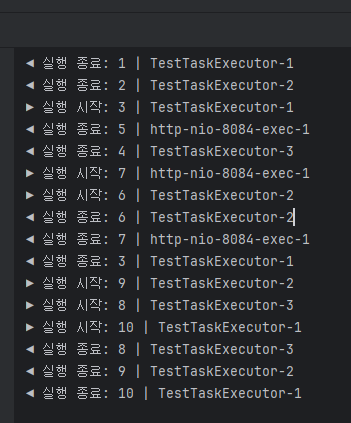
호출 결과를 보면 10번의 작업 모두 유실되지는 않았다.
하지만 쓰레드 이름을 보면 http-nio 이런게 찍혀있는데 메인쓰레드에서 그냥 동기 처리한것으로 보여진다.
이렇게 하면 작업은 유실되지 않지만, 대신 요청 스레드가 느려지게 된다.
3. 반환값으로 상태를 제어한다. (Future / CompletableFuture)
//반환값으로 상태를 제어한다. (Future / CompletableFuture) 를 위한 쓰레드풀
    @Bean(name = "TestTaskExecutor3", destroyMethod = "shutdown")
    public ThreadPoolTaskExecutor TestTaskExecutor3() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(2);
        executor.setMaxPoolSize(3);
        executor.setQueueCapacity(1);
        executor.setThreadNamePrefix("TestTaskExecutor3-");

        executor.setRejectedExecutionHandler((r, ex) -> {
            throw new RejectedExecutionException("작업거부");
        });

        executor.initialize();
        return executor;
    }

   @Async("TestTaskExecutor3")
    public CompletableFuture<Boolean> runTask3(int i) {
        System.out.println(
                "▶ 실행 시작: " + i + " | " + Thread.currentThread().getName()
        );

        try {
            Thread.sleep(3000);

            if (i % 3 == 0) { // 일부러 실패
                throw new RuntimeException("강제 실패: " + i);
            }

            System.out.println("✔ 성공: " + i);
            return CompletableFuture.completedFuture(true);

        } catch (Exception e) {
            System.out.println("❌ 실패: " + i);
            return CompletableFuture.completedFuture(false);
        }
    }


    //컨트롤러 부분
    @GetMapping("/test/future/all")
    public String testFutureAll(){

        List<CompletableFuture<Boolean>> futures = new ArrayList<>();

        for(int i=1; i<= 5; i++){
            try{
                futures.add(service.runTask3(i));
            }catch(RejectedExecutionException e){
                futures.add(CompletableFuture.completedFuture(false));
            }
        }

        CompletableFuture<Void> all = CompletableFuture.allOf(futures.toArray(new CompletableFuture[0]));

        all.join(); //모든 작업 완료 대기

        boolean allSuccess = futures.stream()
                .allMatch(CompletableFuture::join);

        return allSuccess ? "All success" : "partial fail";

    }
비동기 작업에서 작업 거부(RejectedExecution) 는
CompletableFuture 내부가 아니라 Executor(ThreadPool) 레벨에서 발생한다.
CompletableFuture는 말 그대로
어떤 작업의 미래결과를 담는 컨테이너며 작업제출 자체를 보장해주지 않는다.
따라서 스레드 풀이 포화된 상황에서는
작업이 실행되기 전에 RejectedExecutionException 이 발생할 수 있고,
이 예외는 반드시 Executor 쪽에서 처리 전략을 정의해야 한다.
작업 거부가 발생했음에도 이를 처리하지 않으면,
결과적으로 컨트롤러 메서드 내부의 문제가 아님에도 불구하고
스레드풀 레벨의 예외로 인해 HTTP 요청 흐름 자체가 끊어져 500 에러가 발생하게 된다.
이를 방지하기 위해 컨트롤러에서는
RejectedExecutionException 발생 시: 예외를 catch 하여
해당 작업에 대한 대체 결과값 (false) 를 지정해줌으로써
모든 CompletableFuture가 반드시 완료 상태가 되도록 보장해야 한다.
이러한 방식은 작업 실패를 상태값으로 식별할 수 있을 뿐,
실제로 작업 자체의 손실을 막아주지는 못한다.
또한 join()을 호출하는 순간,
HTTP 요청을 처리 중인 스레드는 모든 Future의 완료를 대기하게 되며,
결과적으로 전체 흐름은 동기 방식과 다르지 않게 된다.
1. Fail Fast 방식으로 즉시 실패 처리
가장 단순하고 명확한 방식이다.
비동기 메서드를 호출하는 시점에서
작업 제출이 거부되면 RejectedExecutionException 이 즉시 발생하며,
이 예외는 아직 비동기 스레드로 분리되기 전,
즉 HTTP 요청을 처리 중인 메인 요청 스레드에서 발생한다.
따라서 컨트롤러에서 해당 예외를 catch 하여:
- 즉시 실패 응답을 반환하거나
- 503 Service Unavailable, 429 Too Many Requests 와 같은 상태 코드를 내려줄 수 있다.
이 방식은 서버 보호에 효과적이며,
외부 사용자 요청 처리에 가장 많이 사용된다.
2. 동기 강등(CallerRunsPolicy)을 통한 처리
작업 손실이 허용되지 않는 경우에는
CallerRunsPolicy 를 사용해 작업을 거부하지 않고
호출한 스레드에서 직접 실행하도록 할 수 있다.
이 경우 비동기 작업은 순간적으로 동기 작업으로 강등되며:
- 작업 유실은 방지할 수 있지만
- HTTP 응답 지연이 발생할 수 있다.
관리자 기능이나 내부 시스템처럼
응답 속도보다 정합성이 중요한 경우에 적합한 전략이다.
3. 외부 이벤트 큐(Kafka 등)를 통한 완전한 분리
보다 안정적인 구조에서는
HTTP 요청 흐름과 실제 작업 처리를 완전히 분리한다.
- 요청 시점에는 이벤트만 발행
- 실제 작업은 Kafka, RabbitMQ 같은 외부 시스템에서 처리
이 방식에서는 스레드 풀 포화로 인해
HTTP 요청이 실패하는 상황 자체를 피할 수 있으며,
재시도와 장애 복구에도 유리하다.
4. 작업 거부 시 사용자에게 비동기 알림 제공
HTTP 요청 시점에는 정상 응답을 반환하되,
실제 비동기 작업이 거부되거나 실패한 경우:
- SSE(Server-Sent Events)
- WebSocket
등을 통해 사용자에게 작업 실패 알림을 전달할 수도 있다.
이 방식은 즉시 응답이 필요한 UI 환경에서
사용자 경험을 유지하는 데 효과적이다.