[발표용] Redis
1. Redis란?
Redis는 "Key-Value" 구조의 비정형 데이터를 저장하고 관리하기 위한 오픈 소스 기반의 비관계형 데이터베이스 관리 시스템(NoSQL)
Key-Value라 하면 ex : "Actas" : "2026"
* 비정형데이터 : RDMS와 달리 정해진 규격이 없는데이터, ex: log, json 텍스트, 이미지, 영상
비정형데이터이기 때문에 RDMS 와 같은 높은 정합성의 쿼리나 연산은 부적합하지만, 데이터의 고속 읽기와 쓰기에 최적화 되어있다.
왜 빠른가?
하드웨어적 관점: CPU와의 거리와 속도
메모리는 CPU 바로 옆에 위치하여 데이터 전달 경로가 매우 짧습니다.
- 물리적 위치: CPU 내부에 캐시(L1, L2, L3)가 있다면, 그 바로 다음에 위치하는 저장소가 RAM(메모리)입니다. 반면 DISK(HDD/SSD)는 메인보드의 먼 길을 돌아 연결됩니다.
- 속도 차이: 메모리는 전기적 신호로만 동작하지만, 디스크는 물리적인 헤드가 움직여야 하거나(Seek Time), 인터페이스(SATA 등)의 한계로 인해 속도가 수십~수백 배 느립니다.
* SSD도 전기신호로 동작하지만 메모리와 차이점이 존재합니다.
- 기본적으로 읽/쓰기 하는 단위가 다릅니다. 레디스는 바이트단위로 읽습니다. 하지만 SSD는 데이터를 읽을 때는 페이지 단위로 읽지만, 수정하거나 지울 때는 훨씬 큰 블록(Block) 단위로 처리해야 합니다.
특히 데이터를 덮어쓰려면 기존 데이터를 지우고 다시 써야 하는 '정리 작업'이 필요해서 RAM보다 훨씬 복잡한 과정을 거칩니다.
-또한 RAM은 CPU와 물리적인 메모리 버스라는 전용통로를 이용하는데 CPU와 데이터를 주고받는데 특화되어 있습니다.
소프트웨어적 관점: I/O 오버헤드 제거
단순히 메모리에 있어서 빠른 것뿐만 아니라, 데이터를 처리하는 방식도 다릅니다.
- Disk I/O 병목 제거: 일반적인 RDBMS는 데이터의 안전을 위해 수정 사항을 매번 디스크에 기록(Logging)해야 합니다. 이 과정에서 발생하는 대기 시간(I/O Wait)이 성능의 병목이 되는데, Redis는 이 과정을 생략하거나 비동기로 처리하여 성능을 극대화합니다.
* 비동기 : 앞선 작업이 끝날 때까지 기다리지 않고, 다음 작업을 바로 시작하는 방식 (이것은 Redis의 철학과 연결됩니다. 나중에 설명하겠습니다.)
비동기 작업으로 작업이 완료될때 까지 cpu가 멍하니 대기하는 블로킹시간을 줄여줍니다.
"벤치마크 통계를 보면 Redis는 RDB 대비 응답 속도는 10배 이상 빠르고, 초당 처리량은 20배 이상 높습니다."라고 나옴.
클로드는 10만배 차이라고도 함. 좀 오바하는거같음 이건.
---> 간단요약: 메모리 cpu 바로 옆에 있고 전기신호를 바이트 단위로 처리하고 데이터 이동 버스가 직통선이라서 전송속도자체가 빠름.
Redis의 기본철학
redis는 기본적으로 복잡한 트랜잭션 정합성보다 극한의 속도와 처리량을 선택했습니다.
그렇기 때문에 Redis가 채택한 기본 아키텍처 구동방식은 "싱글스레드" 입니다.
보통 쓰레드가 많은 멀티쓰레드가 더 빠른거아니냐? 라고 생각할 수 있습니다. 여기서 Redis의 철학의 의미는
복잡한 N차선 도로보다 잘 닦이고 막힘없는 1차선을 추구하는 것입니다.
- 멀티쓰레드 환경은 기본적으로 여러 명이 접근하여 데이터 읽기/수정이 일어납니다.
이과정에서 데이터가 깨질 수 있어 기본적으로 RDB나 대부분의 시스템은 Lock을 걸어버립니다.
이 Lock이 한번 걸려버리면 엄청난 성능 병목을 유발 할 수 있습니다.
ex: 여러명의 요리사가 좁은 주방에서 서로 부딪히며 비켜봐 하며 정신없이 일하는것과 혼자만 주방에 있지만
씹에이스 요리사 한명이 캐리하는 상황이라고 보묜 됨. (배가 많으면 산으로 간다)
- 싱글스레드인데 어덯게 수만 개의 요청을 동시 처리하는가?
데이터를 가져오는 시간을 기다리지 않는다, 나는 준비된 놈들만 처리할 것이다. 이런 느낌임
또한 애초에 멀티쓰레드환경이면 쓰레드가 스케줄링 되면서 컨텍스트 스위칭 비용이 발생함.
스레드가 많을수록 CPU가 "지금 누구 차례지?" 를 계속 계산해야 해서 오히려 오버헤드가 생김
이벤트 루프(Event Loop) 기반으로 동작합니다. I/O 멀티플렉싱(epoll/kqueue)을 통해 수천 개의 클라이언트 소켓을 단 하나의 스레드로 감시하다가, 데이터가 준비된 소켓에만 즉시 반응합니다. 대기 시간에 CPU를 낭비하지 않는 구조
이벤트 루프 = "일이 생겼나? 생겼나? 생겼나? 오 생겼다! 처리! 또 생겼나? 생겼나?..." 를 무한반복하는 것
이건 이해가 잘안갈거 같아서 AI한테 예시 가져옴
<멀티스레드방식>
클라이언트 1 요청 → 스레드 1 생성 → 처리중... (대기)
클라이언트 2 요청 → 스레드 2 생성 → 처리중... (대기)
클라이언트 3 요청 → 스레드 3 생성 → 처리중... (대기)
클라이언트 4 요청 → 스레드 4 생성 → 처리중... (대기)
클라이언트 5 요청 → 스레드 5 생성 → 처리중... (대기)

스레드 1: "나 지금 이 데이터 쓸거야!"
스레드 2: "나도 그 데이터 써야해!"
스레드 1: "잠깐 Lock 걸게"
스레드 2: "...기다림"
스레드 3: "...기다림"
스레드 4: "...기다림"
하나가 Lock 걸면 나머지가 전부 멈춰서 기다림. 그리고 스레드가 1000개면 CPU가 "지금 누구 차례지?" 를 1000번 계산해야 해요. 이게 컨텍스트 스위칭 비용임.
근데 Redis는 혼자 처리함 락 걸 필요조차 없는것.
- 멀티스레드 (Blocking): 스레드 A가 "DB에서 데이터 가져와!"라고 시키면, 데이터가 올 때까지 그 스레드는 멍하니 서서 기다립니다. 이때 CPU 자원을 일부 점유하면서도 아무 일도 안 하는 '낭비'가 발생합니다. ---> 이게 IO 바운드임.애초에 ai 연산 작업이 아닌 이상 대부분 작업은 데이터를 통한 io 바운드가 cpu 바운드보다 압도적임. 사실 멀티쓰레드도 비동기 구현가능함. 근데 좀 복잡하고 관리포인트가 늘어남. 야근지옥임 관심있으면 WebFlux 공부ㄱㄱ
- 이벤트 루프 (Non-Blocking): Redis는 "데이터 가져와!"라고 던져놓고 바로 다음 손님의 주문을 받으러 갑니다. 데이터가 도착했다는 신호(Event)가 오면 그때 다시 그 일을 마무리합니다. 즉, CPU가 '기다리는 시간' 자체가 0에 수렴하게 설계되어 있습니다.
여기서 멀티스레드나 이벤트 루프나 어차피 앞선 처리가 끝날때까지 기다려야 하잖아? 라고 생각할 수 있음.
근데 좀 다름 컨텍스트 스위칭 비용도 없고. lock이 걸린다는거자체가 비용임. 임계구역을 설정해버리면
lock걸렸니? lock 풀렸니? 요러면서 일일히 체크하는 자원 낭비 발생함
근데 한번에 딱 하나의 명령만 실행함. 그래서 긴 처리시간이나 복잡한거 줘버리면 뒤에 다 밀림.
이러면 다운 될수도
너무 길어서 Redis가 뭐가 좋고 어떤 방식으로 동작하는지는 그만 설명함 다른것들도 중요함
그래서 언제 쓰는데?
1. 캐싱 (가장 많이 쓰는 방식)
DB 앞에 Redis를 두고 자주 찾는 데이터를 미리 넣는거임
- 애플리케이션이 데이터를 찾을 때 먼저 Redis를 확인합니다.
- 데이터가 있으면 (Cache Hit) 바로 반환 (엄청 빠름!).
- 데이터가 없으면 (Cache Miss) DB에서 가져온 뒤 Redis에 저장하고 반환합니다.
실제로 내 생각은 MES에서 콤보박스나 메뉴, 사용자의 API 호출횟수 이런것들 있잖아여
별것도 아닌데 디스크에서 조회해야 되고 네트워크 비용 발생시키는 것들.
실제로 한 화면은 콤보박스 10개 있는것도 있을텐데 이거 어떻게 보면 10번 왔다리갔다리 하고 10번 디스크 뒤지는것임.
또 SY폴리텍 하면서 생산계획 대비 조회를 하는데 재고를 조회하는 프로시저 같은것을 2번씩 타고 앉아있어서
하나 조회하는데 1분30초 걸림. 이거 캐싱하니깐 30초로 줄어듬.
2. 세션 관리
로그인 정보같이 분산서버 환경에서 공유해야 하는 데이터를 저장할때 많이 씁니다.
유저 → 로드밸런서 → 서버A
                  → 서버B
                  → 서버C
우리는 세션정보가 db에 있으니 어느 서버가 죽어도 상관없음 근데 부하량 차이가 프로젝트가 커질수록 압도적임.
요청 올때마다 세션 확인함. 계속 db 들락날락 해야함. 모든 요청마다 발생함. jwt 구현할때 많이 씀.
레디스 캐싱 전략
<읽기 전략>
-Look aside Cache 패턴
캐시를 한 번 접근하여 데이터가 있는지 판단후, 있으면 캐시의 데이터를 사용 없으면 실제 DB or API 호출
반복적인 읽기가 많은 호출에 적합하다.
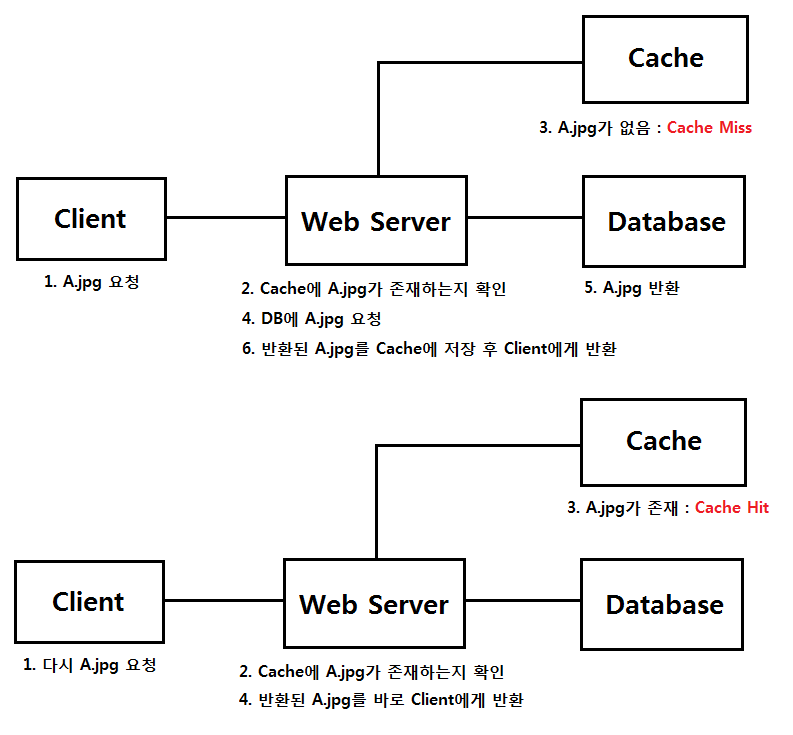
하나 더 있는데 Read Through 패턴이라고 있음 근데 이거 잘안씀 (누가 주체냐의 차이임)
<쓰기 전략>
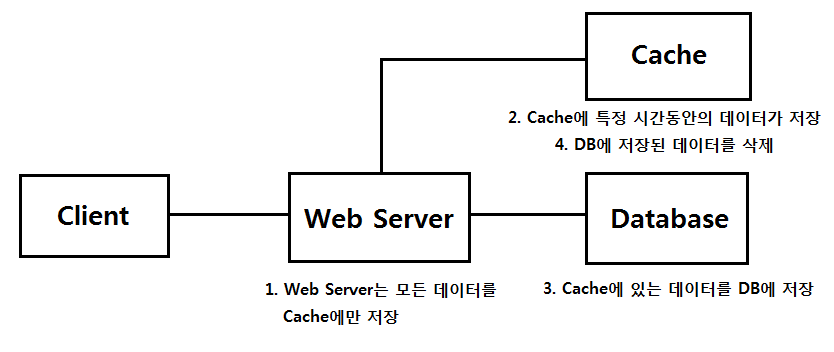
-Write Back 패턴 ( batch)
쓰기 작업이 많아서, insert 쿼리를 일일이 날리지 않고 한꺼번에 배치 처리를 하기 위해 사용한다.
즉, 데이터 저장할때 DB에 바로 저장하지 않고, 캐시에 모아서 일정 주기 배치 작업을 통해 DB에 반영한다.
클라이언트가 Redis에만 먼저 쓰고, Redis가 나중에 백엔드 DB(MySQL/PostgreSQL 등)에 비동기적으로 저장하는 패턴
애플리케이션은 DB로 직접 쓰기(write) 하지 않음 → 응답 속도 빨라짐
Redis가 여러 write 요청을 모아서(batch) DB에 쓰니 트래픽을 효율적으로 처리.
하지만 반드시 DB와 일치해야 하고 실시간 정합성이 중요한 재고 수량, 트랜잭션, 계좌 잔액 등에서는 사용하지 않는다.
또한 캐시 서버가 죽으면 데이터가 유실 될 수 있다.
- redis는 Write Back전략으로 보통 사용하지 않는다. Write Back은 로컬 서버의 캐시 메모리를 이용한다.
-Write Around 패턴
Write Through 패턴보다 빠르며
데이터 쓰기(write)를 캐시에 저장하지 않고, 바로 DB에만 저장하는 방식.
단, 읽기(read) 시에 캐시가 비어 있으면 그때 DB 값을 가져와 캐시에 넣는다.
rdb 및 aof
✦ RDB (snapshotting) 방식
레디스는 인메모리 데이터를 주기적으로 파일에 저장하는데, 레디스 프로세스가 장애로 인해 종료되더라도
해당 파일을 읽어들이면 이전의 상태를 복구 할 수 있다.
셋팅을 하지 않더라도 레디스는 자동으로 .rdb 라는 확장자의 파일에 인메모리 데이터를 저장한다.
특정 시점의 메모리 데이터를 바이너리 파일형태로 디스크에 저장하는 방식이다.
.rdb 파일은 AOF 파일보다 사이즈가 작다는 특징이 있으므로 로딩속도가 AOF보다 빠르다.
하지만 스냅샷을 추출하는데 시간이 오래걸리며 도중에 서버가 꺼지면 이후의 데이터를 모두 사라진다는 단점이 있다.
RDB 기능은 Redis 설정파일인 redis.conf 파일을 수정하면 된다. (윈도우는 redis-windows-service.conf)
| 설정항목 | 설정사례 | 설명 |
| save | 900 1 | 900초(15분) 이후 1개의 쓰기 발생 |
| save | 300 10 | 300초(3분) 이후 10개의 쓰기 발생 |
| save | 60 10000 | 60초 이후 10,000개의 쓰기 발생 시 디스크에 데이터 복제 |
| stop-writes-onbgsave-error | yes |
|
| rdbcompression | yes | dump.rdb 파일을 LZF로 압축 |
| rdbchecksum | yes |
|
| dbfilename | dump.rdb | 변경 지정 가능 |
| dir | ./ | dump.rdb 파일과 AOF 파일 생성 위치 |
* SAVE는 순간적으로 redis의 동작을 정지시키고 해당 스냅샷을 디스크에 저장하는 blocking 방식이다.
* BGSAVE는 백그라운드 SAVE라는 의미로 별도의 자식 프로세스를 띄운후, non-blocking 방식으로 스냅샷을 디스크에 저장한다. 하지만 이 방식은 fork를 하기때문에 메모리를 거의 두배 가량 사용하게 된다.
✦ AOF(Append Only File) 방식
레디스의 모든 write/update 연산 자체를 모두 로그파일에 기록하는 형태이다.
기본적으로 appendonly.aof 파일에 기록된다.
실행 순서
1. 클라이언트가 레디스에 업데이트 명령어 요청
2. 레디스는 해당 명령을 AOF에 저장
3. 파일쓰기 완료되면 해당 명령 수행하여 메모리 내용 업데이트
RDB파일은 바이너리 파일이라서 수정이 불가능 하지만, AOF 파일은 텍스트 파일이라서 편집이 가능하다.
| 설정항목 | 설정사례 | 설명 |
| appendonly | yes | AOF 파일 사용 여부 |
| appendfilename | "appendonly.aof" | AOF 파일 이름 지정 |
| appendfsync | always | 모든 쓰기(write) 명령을 파일에 순차 기록하는 방식인데, 기록한 내용을 디스크에 실제로 언제 flush(동기화)할 것인지 결정하는 옵션이 바로 appendfsync 설정 always : 모든 쓰기 명령마다 fsync 실행 (즉시 디스크에 반영) , 가장 안전하지만 성능 느림 everysec : 1초마다 디스크에 flush + fsync no : 레디스가 fsync를 직접 호출하지 않고 OS에 맡긴다. 성능은 최고지만 장애시 여러초~수십초 분량 데이터 손실이 가능하다. 일반적으로 리눅스는 30초이다. |
| no-appendfsync-on-rewrite | no | rewrite 중에는 fsync를 잠시 하지 말고 나중에 한 번 몰아서 해라 |
| auto-aof-rewrite-percentage | 100 | AOF 파일의 크기가 얼마나 커졌을 때 자동으로 rewrite를 실행할지 결정하는 옵션 , 기본값은 100% |
| auto-aof-rewrite-min-size | 64mb | AOF 파일 초기화 및 재기록 시작을 위해 파일 크기를 지정(‘0’으로 지정 시 AOF 파일 초기화 없음) |
주의할 점 :
100번의 increment 작업을 수행하여 데이터를 100으로 해놔도
aof 방식은 기록된 파일을 읽어와 복구하려면 불필요하게 100번의 문장을 수행하게 된다.
RDB 방식이면 100이란 값을 한번만 쓰면 되는데 말이다.
RDB방식에 비해 백업 데이터가 크기도 하고, 서버 자원 또한 많이 잡아먹는다.
기본 명령어 :
keys * : 모든 키 조회 (근데 이거 쓰지마셈)
KEYS * 실행
→ Redis가 전체 키를 다 뒤짐
→ 키가 100만개면 100만개 전부 스캔
→ 그 동안 다른 요청 전부 대기
→ 서비스 전체 멈춤

넷플릭스, 트위터 개발자가 KEYS * 한 번 날렸다가 수초간 전체 서비스 응답 없음 터진 사례 있어요. 운영환경에서 절대 쓰면 안 되는 명령어예요.
keys set* : set로 시작하는 키 조회
sscan : 전체 멤버를 한 번에 가져오지 않고,
커서(cursor)를 이용해 여러 번 나누어서(iterative) 조회하는 명령어
Strings
- set key 10 , decr key : 1씩 숫자 감 / decrby key 5 : 5씩 감소 / incr key : 1씩 증가 / incrby key 3 : 3씩 증가
- mset key1 hello key2 Redis / mget key1 key2 : 여러 키를 조회
- setnx key Hello , setnx key Redis : 해당 키로 이미 데이터가 있으면 실패 동일한 키가 없을경우에만 저장
- append : 기존에 있는 키에 값을 추가 or 키가없으면 set
set key1 Hello , append key1 Redis : 결과10 / get key1 : HelloRedis / append key2 "Hello World" : 신규 set
- setex key 5 value : 5초뒤 값 소멸
- set key "This is Redis Server" , getrange key 0 3 : 문자열 범위 조회 (결과 : This)
Hashes
Key 하나에 여러 개의 field/value 쌍을 저장하는 자료구조
user-1 → {name: "Tom", age: "25", country: "KR"}
hset user-1 email sawq8231@naver.com language korean : 값 넣기 (이메일 언어)
hgetall user-1 : user-1 키에 field/value 쌍 모두 조회
hget user-1 email : 해당키의 email 필드 조회
hlen user-1 : 키의 필드 갯수 조회
hmget user-1 email language : 여러 필드 한번에 조회
Sorted Sets
set에 score라는 필드가 추가된 형태이다. Sorted Set은 Set의 특성을 그대로 가지며 추가적으로 저장된 member들의 순서도 관리함.
sorted set에서 데이터는 오름차순으로 내부 정렬
zadd myzip 60 "GeongGi"
zadd myzip 20 "Seoul"
zrange myzip 0 -1 : 모든 범위 조회
zrange myzip 0 1 : 2개 조회
zrem myzip "Seoul" : 집합에서 해당 멤버 삭제
-- redis에서 스트레스 테스트 하는 방법 :
redis-cli를 하지말고
redis-benchmark -n 5000 -d 100000 -t hset -r 5000 -c 500
| -n | --requests | 총 요청 수 | -n 5000 → 5000회 명령 실행 |
| -d | --data-size | 요청에 사용될 값의 크기(Byte) | -d 100000 → 100KB 크기 value |
| -t | --tests | 테스트할 Redis 명령 | -t hset → HSET 명령만 테스트 |
| -r | --random-key | 랜덤 키 범위 | -r 5000 → 5000개의 랜덤 key 생성 |
| -c | --clients | 동시 접속 클라이언트 수 | -c 500 → 500개 동시 연결 |
이런식으로 사용합니다. 이게 전부입니다. 진짜로 물론 더욱 많은 자료형과 명령어 있는데 AI한테 물어보거나
인터넷 서치하면서 사용하지 다 외우고 다니지 않습니다.
REDIS는 관련 개념이 너무 많음 이정도 알면 개발할때 그냥 써도됨.
여기서 DEEP 하게 들어가면 Redis 장애상황 대응 (failover 및 가용성확보) 도 있고 분산 redis 환경(master & replica 구조),
Sentinel 구조 ,
redis를 이용한 분산락 이런것들도 있음. 근데 이거 설명하려면 일주일 걸림. 이건 데브옵스영역
애초에 이것들은 실습해보는게 직빵
끄읕