[컴퓨터 구조] 이진법과 십육진법 및 문자집합과 인코딩
<이진법>
0과 1로 수를 표현하는 방법이다.
1을 넘어가는 시점에서 자리 올림을 하여 0과 1만으로 모든 수를 표현하는 방법이다.
| 십진법 | 이진법 |
| 0 | 0 |
| 1 | 1 |
| 2 | 10 |
| 3 | 11 |
| 4 | 100 |
| 5 | 101 |
| 6 | 110 |
| 7 | 111 |
| 8 | 1000 |
| 9 | 1001 |
| 10 | 1010 |
이진법에서 보수 : 어떤 이진수를 기준으로 반대되는 값을 나타내는 개념
이진법에서 주로 사용되는 보수는 1의 보수()와 2의 보수 두 가지이다.
1의 보수 구하는 방법:
- 이진수의 각 비트를 반전(0을 1로, 1을 0으로)시킨 값이다. ex: 1010 -> 0101
- 2의 보수 구하는 방법: 이진수의 음수를 표현하는 방법으로, 해당 이진수의 1의 보수에 1을 더한 값 ex: 1010 -> 0101 + 1 = 0110
-1011의 보수는 0101이고 5를 이진법으로 표기한 0101로 같은것인데 어떻게 구별하는가 -->
cpu내부에 플래그레지스터가 있는데 양음 표기가 담겨있다.
이진법으로는 표현하면 숫자의 길이가 너무 길어진다 --> 16진법을 대체로 많이 사용된다.
<십육진법>
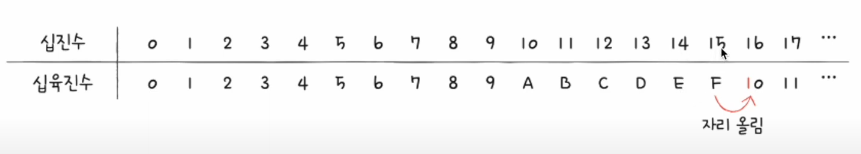
0~9와 A~F 까지의 16가지 문자와 숫자를 통해 표현하는 방법
<진수 변환>
이진수 -> 십육진수 변환
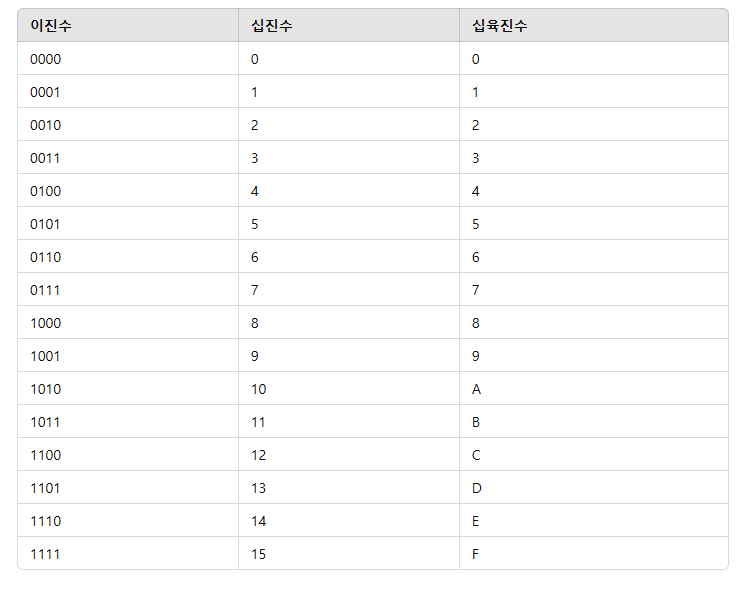
십육진수의 글자하나는 16이 2의 4승이므로 이진수로 표현하면 4비트가 나온다.
문자 하나를 이진수 4개로 표현하면 된다.
이진수는 2진법이고, 십육진수는 16진법이므로, 4개의 이진수 자리가 1개의 십육진수 자리와 정확히 대응한다.
<이진수 -> 십육진수>
1.이진수를 오른쪽에서부터 4자리씩 그룹화를 해준다. (만약 4로 떨어지지 않으면 왼쪽에 0을 추가하여 4자리 맞춤)
2. 각 4자리 그룹을 16진수로 변환한다.
<십육진수 -> 이진수>
십육진수의 각 자리 숫자를 4자리 이진수로 변환하면 된다.
십육진수는 16진법이고, 이진수는 2진법이기 때문에 각 자리 숫자에 4개의 이진수 비트가 대응된다.
1. 십육진수의 각 자리 숫자를 분리한다.
2. 각 숫자를 4자리 이진수로 변환한다. (필요시 이진수 왼쪽에 0을 붙혀 4자리로 맞춰준다.)
3. 변환된 이진수를 이어붙히어 결과를 얻는다.
컴퓨터가 0 과 1로만으로 문자를 이해하고 표현하는 방법
<문자집합>
문자 집합: 컴퓨터가 이해할 수 있는 문자의 모음
인코딩 : 문자를 0과 1로 이루어진 문자 코드로 변환하는 과정
디코딩: 0과 1로 표현된 문자 코드로 우리가 이해 가능한 문자로 변환하는 과정
이것들을 바탕으로 우리가 가장 범용적이게 사용하는 문자 체계 집합에는 아스키 코드가 있다.
이러한 문자집합을 참고하여 컴퓨터가 이해할 수 있는 언어로 변환한다.
<아스키 코드>
아스키 코드는 1963년에 처음 도입되었으며, 문자, 숫자, 제어 문자 등을 특정 숫자 값(정수)에 매핑하여 저장한 표준이다.
알파벳, 아라비아 숫자, 특수문자 및 제어문자로 구성되어 있다.
7비트로 하나의 문자를 표현할 수 있다. (8비트중 하나의 비트는 오류검출을 위해 사용되는 패리티 비트이다.)
문제점: 아스키 코드는 7비트로 하나의 문자를 표현하기 때문에 128개보다 많은 문자를 표현할 수 없다.
그래서 한글이 안된다.
그래서 언어별로 인코딩 방식이 등장한다.
<EUC-KR>
KS x 1001 KS X 1003 문자집합 기반의 한글 인코딩 방식 (중요하지않다.)
글자 하나에 2바이트 크기의 코드를 부여한다. == 16비트이므로 16자리 십육진수로 표현(글자하나당)
하지만 여전히 모든 글자를 표현하기에는 벅차다.
그리고 이렇게 국가언어마다 문자집합이 분리되어 있으면 통합할 필요가 있다.
이러한 문제점을 바탕으로 유니코드가 등장하였다.
<유니코드>
통일된 문자 집합
한글, 영어, 특수문자 표현 가능
utf-8, utf-16, utf-32 등등...