Redis
Redis
오픈 소스 기반의 인메모리 데이터 저장소로, 빠른 성능과 다양한 데이터 구조 지원이 특징인 NoSQL 데이터베이스
키-값 구조를 가지며 이러한 단순한 구조로 인하여 일반RDB같은 쿼리 연산은 지원하지 않지만 IO에 대해 특화되어있다.
데이터에 대한 연산이 일반RDB와 달리 디스크가 아닌 메모리에서 처리되기 때문에 압도적인 속도차이를 보인다.
레디스의 주요 특징
✅ 초고속 데이터 처리 가능 : RAM에서 처리되기 때문에 디스크보다 빠르다.
✅ 단순한 Key-Value 형식뿐 아니라 다양한 데이터 구조를 지원한다.
✅ 휘발성이 있는 인메모리 데이터베이스이지만 영속성을 보장한다. (RDB, AOF 를 이용)
✅ 메시지 브로커 역할을 할 수 있는 PUB/SUB 기능을 제공한다.
✅ 메모리에 의존적이므로 RAM 용량이 제한된다.
✅ RDBMS처럼 쿼리 연산을 미지원
✅ 메모리의 휘발성으로 인하여 데이터 유실 가능성이 있다.
✅ 매모리 동적 할당시 외부 단편화 문제 발생 가능성이 있다.
DataStructures
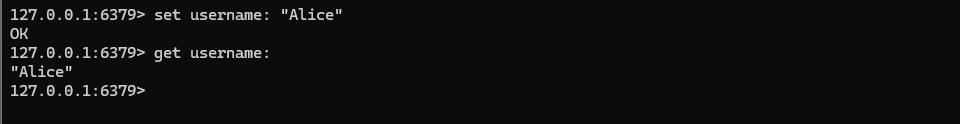
1. String : 기본데이터타입이며 문자열 저장이 가능하다.
2. Bitmap : 1비트(0 또는 1) 값 저장 가능 → 효율적인 공간 사용 가능 , 출석 체크, 사용자 로그인 기록 등)에 적합
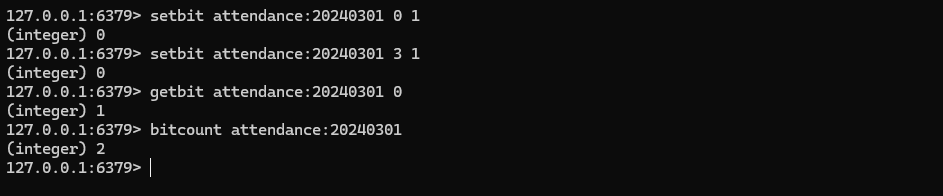
효율적인 공간 활용과 빠른 조회가 가능해서 출석 체크 기능에 많이 사용된다.
SETBIT attendance:20240301 0 1 # 0번째 비트를 1로 설정 (출석 체크) , 사용자아이디가 0인 회원 출석 처리
SETBIT attendance:20240301 3 1 # 3번째 비트를 1로 설정 (출석 체크) , 사용자아이디가 3인 회원 출석 처리
GETBIT attendance:20240301 0 # 0번째 비트 값 조회 → 1
BITCOUNT attendance:20240301 # 1이 설정된 비트 개수 → 2
<특정기간 출석 여부 확인>
BITOP AND attendance:range attendance:20240312 attendance:20240313 attendance:20240314
BITCOUNT attendance:range # 3일 동안 연속 출석한 사용자 수
3. Lists : 순서를 유지하며 항목별로 분류하여 저장하기 적합하다

lpush를 통하여 왼쪽에서 넣을 수 있고 rpush를 통해 오른쪽으로 넣을 수 있다. (Queue 방식)
lpop을 통하여 왼쪽에서 삭제가 가능하고 LRANGE를 통해 범위를 0 -1 로 설정하여 전체조회가 가능하다.
4. Hashs : Key-Value 쌍을 저장하는 자료구조
HSET user:100 name "Alice" age 25   # 필드 저장
HGET user:100 name                  # 필드 값 조회 → "Alice"
HGETALL user:100                    # 모든 필드 조회 → {"name": "Alice", "age": "25"}
HINCRBY user:100 age 5              # age 값 5 증가
HDEL user:100 age                    # 특정 필드 삭제
5. Sets : 중복 허용 X, 순서 없음
SADD visitors "Alice" "Bob" "Charlie"  # 값 추가 (중복 X)
SADD visitors "Alice"                  # 중복 데이터 추가 시 무시됨
SMEMBERS visitors                       # 전체 조회 → {"Alice", "Bob", "Charlie"}
SISMEMBER visitors "Alice"              # 특정 값 포함 여부 → 1 (true)
SREM visitors "Charlie"                 # 특정 값 삭제
SCARD visitors                          # 집합 크기 조회 → 2
6. Sorted Sets : 중복허용x, 저장시에 처음부터 score순으로 정렬되며 같다면 사전순으로 정렬, 랭킹 시스템에 적합
ZADD leaderboard 100 "Alice"    # Alice 점수 100
ZADD leaderboard 200 "Bob"      # Bob 점수 200
ZADD leaderboard 150 "Charlie"  # Charlie 점수 150
ZRANGE leaderboard 0 -1 WITHSCORES  # 점수순 정렬 조회 → [Alice, 100, Charlie, 150, Bob, 200]
ZRANK leaderboard "Alice"       # Alice의 랭킹 (0부터 시작) → 0
ZREVRANGE leaderboard 0 -1      # 높은 점수순 조회 → ["Bob", "Charlie", "Alice"]
ZINCRBY leaderboard 50 "Alice"  # Alice 점수 +50 → 150
7. HyperLogLogs : 많은 데이터를 다룰때 사용, 고유한 요소(Unique Elements) 개수를 추정하는 자료구조, 웹사이트 방문자 수를 추적할때 용이하다.
PFADD visitors "Alice" "Bob" "Charlie"  # 고유 방문자 추가
PFADD visitors "Alice"                  # 이미 있는 값 → 카운트 변동 없음
PFCOUNT visitors                         # 고유 방문자 수 조회 → 3
Redis의 영속화
레디스는 인메모리 데이터베이스 특성으로 메모리를 활용한다.
근데 메모리는 휘발성을 가지는 특징이 있다. 데이터를 영구히 저장하지 못한다.
하지만 redis의 RDB , AOF 방식을 이용하면 백업 및 복구가 가능하다. (데이터 영속화 가능)
- RDB(RedisDataBase)
메모리의 데이터를 스냅샷을 통하여 디스크로 저장한다. 하지만 스냅샷 이후 변경된 데이터는 복원이 불가능하다.
정 시점의 데이터를 디스크에 저장하여 시스템이 종료되더라도 데이터를 복구할 수 있다.
특정 시점의 데이터를 dump.rdb 파일로 저장하고, 시스템이 재시작되면 복구 가능.
dump.rdb파일은 윈도우 기준으로 "C:\Program Files\Redis" 경로에 존재한다.
레디스 서버를 종료하고 다시 실행해도 해당 키가 여전히 남아있는데 자동으로 덤프파일을 읽는 기능이 있다.
관련 명령어
✔ SAVE ( 명령어 : redis-cli save)
-동기적으로 즉시 저장 , 이 방식은 싱글스레드환경인 레디스에서는 해당 작업이 끝날때 까지 다른 요청이 대기상태에 빠질 수 있다.
✔ BGSAVE (명령어 : redis-cli BGSAVE)
비동기적으로 백그라운드 환경에서 작업을 실행한다.
이 방법은 새로운 프로세스를 fork(복제) 하여서 백그라운드에서 실행되기 때문에 메모리 사용량이 증가한다.
- AOF(Append only File)
데이터 변경 감지가 이루어지면 즉시 로그형식으로 appendonly.aof 파일에 기록하는 방법이다.
최선정보로 백업가능, 하지만 로딩속도가 느리고 파일 크기가 크다. 주로 장애발생시 복구로 이용
redis 재시작시 AOF파일을 읽어 모든 명령어를 재실행하여 복구한다.
이 방법은 파일에 대한 쓰기작업이 빈번히 일어나고 양이 많기 때문에 파일 크기가 커진다는 단점이있다.
그렇기 때문에 로딩시에도 읽어올때 속도가 느리다.
< aof 파일 생성 위치는 redis.windows.conf에서 설정 >
dir "C:/Program Files/Redis/data/"  # AOF 파일 저장 경로
appendfilename "appendonly.aof"      # AOF 파일명
appendonly yes                        # AOF 활성화
해당 기능을 활성화 하려면 redis.windows.conf 에서 아래 설정을 변경해야 한다,
appendonly yes  # AOF 사용 (기본값: no)
appendfilename "appendonly.aof"  # AOF 파일 이름
AOF 동기화 모드 설정관련
| 옵션 | 설명 | 성능 | 데이터안전성 |
| always | 매번 디스크에 기록 | 낮음 | 안전 |
| everysec | 1초마다 디스크 동기화 | 중간 | 중간 |
| no | 운영체제가 디스크에 알아서 기록 | 좋음 | 낮음 |
aof 파일이 비대해지는 것을 방지하기 위해서 압축기능을 제공한다.
아래와 같이 설정을 통하여 가능하다. (파일위치 : C:\Program Files\Redis\redis.windows.conf )
auto-aof-rewrite-percentage 100  # 현재 파일 크기가 기준의 100% 이상 증가하면 리라이팅
auto-aof-rewrite-min-size 64mb   # 최소 64MB 이상일 때만 리라이팅
명령어를 통한 실행 : redis-cli BGREWRITEAOF
| 항목 | AOF | RDB |
| 방식 | 모든 명령들을 순차적으로 기록 | 일정 주기로 스냅샷 |
| 데이터 손실 | 적음 | 마지막 스냅샷 이후 데이터 손실 |
| 복구속도 | 느리다. | 빠르다 |
| 디스크사용량 | 많다. | 적다. |
| 성능 | 디스크 IO 부담으로 인해 느리다. | 메모리 기반으로 빠르다. |
사용용도
캐싱 : 단순한 key-value구조이기 때문에 저장이 간편하다. 인메모리 방식이기 때문에 접근하여 데이터를 가져오는 작업속도가 빠르다 (1ms 이하)
세션 스토어 : 인증 토큰을 저장하는 용도
랭킹 집계등을 통하여 Ranking 보드로 사용가능하다
실시간 브로커, 메세지 브로커
Redis IO 전략
* 읽기 전략
1.look-aside
가장 일반적으로 사용하는 캐싱 방법
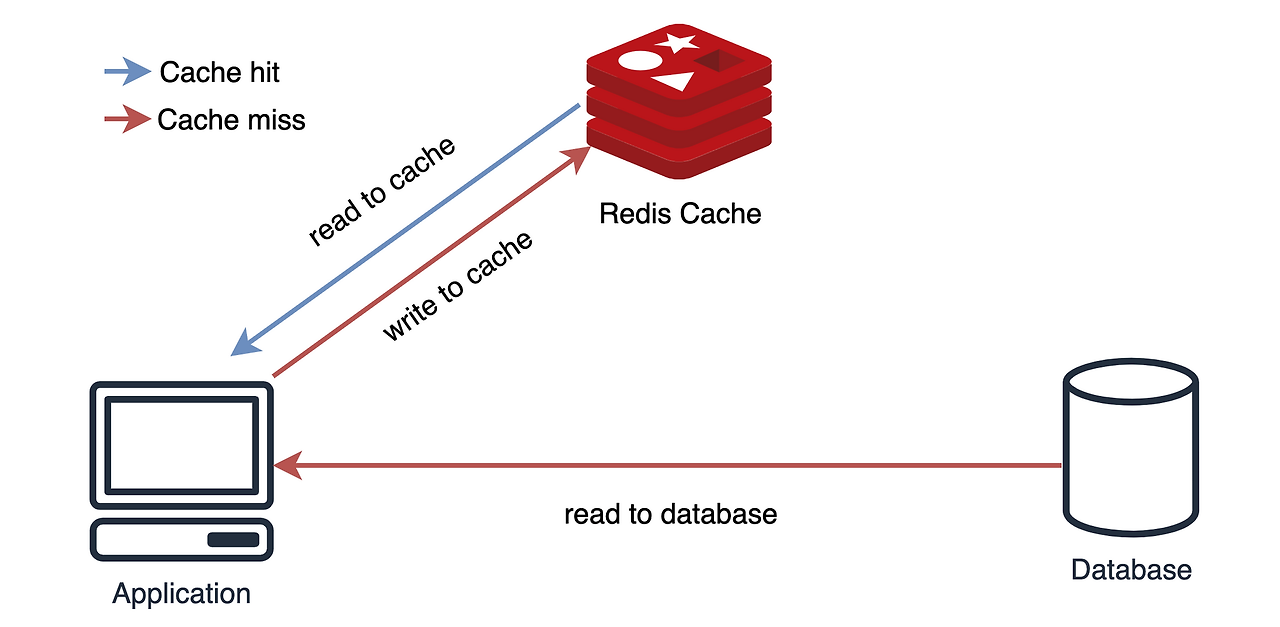
만약 레디스에 해당 키가 없다면 데이터베이스에서 서치하여 적재한다.
캐시미스가 자주 발생한다면 DB성능에 부담을 줄 수 있다. 데이터 일관성 문제가 있을수 있다.
2. Read Through
캐시에서만 데이터를 읽어오는 전략
Cache miss가 발생한다면 캐시는 DB에서 데이터를 검색하고 캐시에 자체 업데이트한 뒤 앱에 데이터를 보내줍니다.
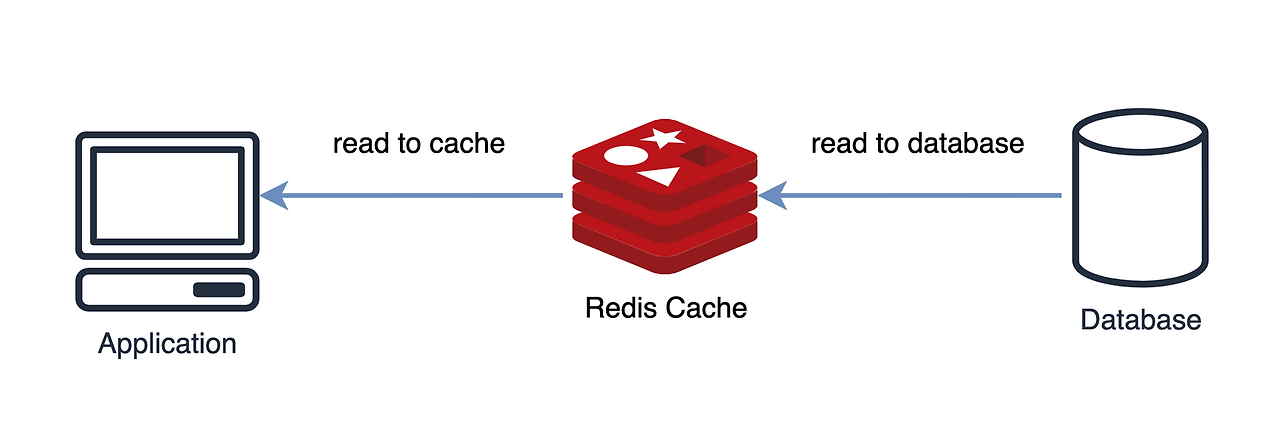
1번은 캐시에 데이터가 없으면(DB 조회 후) 애플리케이션이 직접 캐시에 저장
2번은 캐시에 데이터가 없으면 캐시 시스템 자체가 DB에서 데이터를 조회하고 자동으로 캐시에 저장
* 쓰기 전략
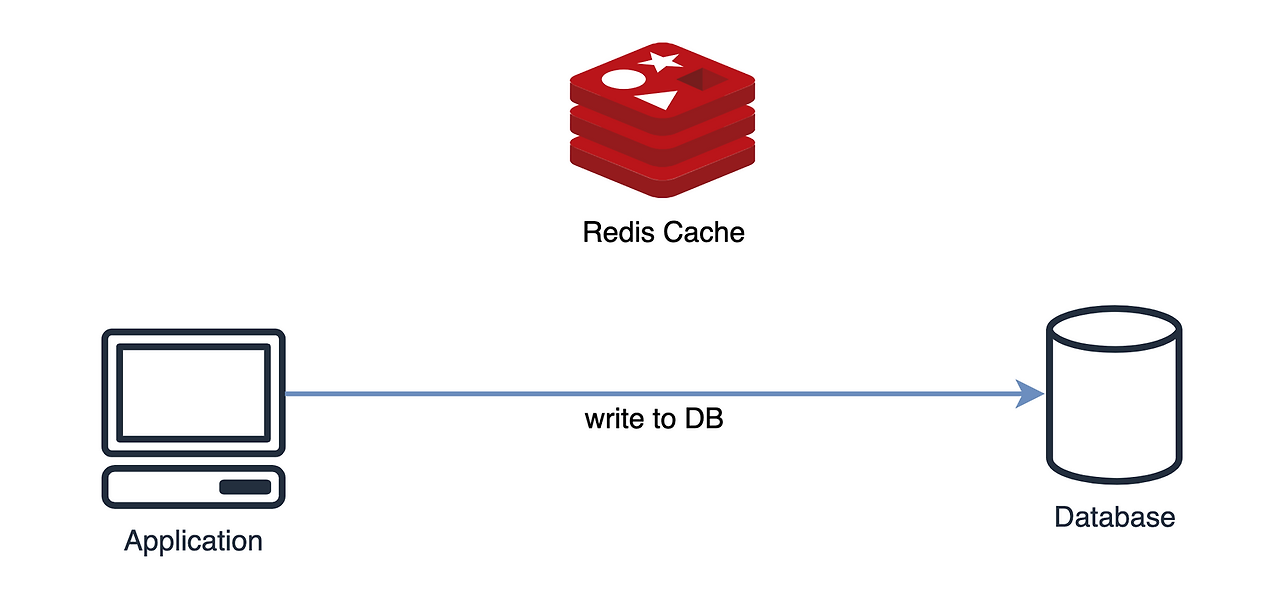
1.Write-Around 방식
모든데이터는 DB에 저장하고 캐시미스가 발생한경우에만 DB에서 끌어온다.
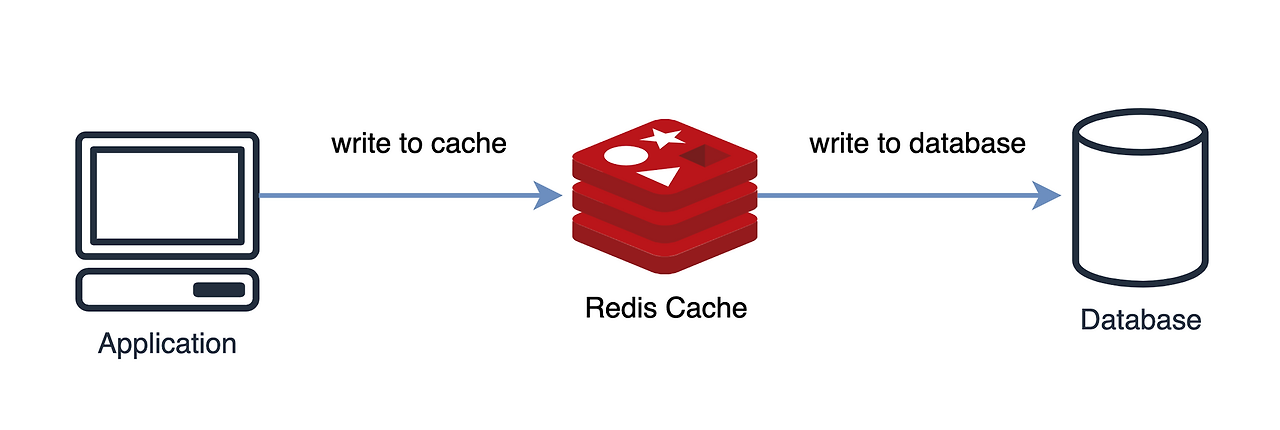
2.Write-Through
데이터를 DB와 캐시에 모두 저장한다. 항상 최신정보를 가지지만 저장시에 속도가 느리고
캐시가 되지 않을 데이터를 넣을수도 있기 때문에 리소스 낭비가 올 수 있다. (만료기간 설정을 해주는게 좋음)
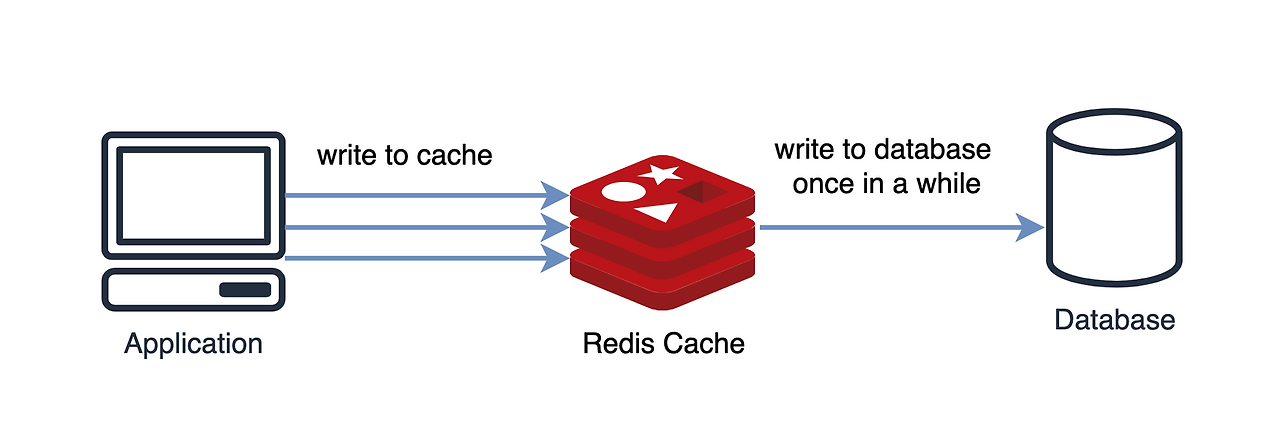
3.Write-back
캐시에서 데이터가 변경될때 즉시 DB에 밀어넣지 않고 캐시에 저장후, 특정 조건이 충족되면 한번에 밀어넣어주는 방식이다.
디스크에 접근을 최소화하여서 성능이 좋지만 밀어넣기전 시스템이 다운되면 데이터가 유실될 위험이 있다. 또한 일관성(Consistency) 문제가 발생할 수 있다.
REDIS 아키텍처 설계 전략
Redis는 초고속 성능을 자랑하는 인메모리 데이터베이스로, 캐싱, 메시징, 세션 관리, 실시간 분석 등의 다양한 분야에서 활용됩니다. 하지만 단순히 빠른 성능만을 목적으로 구축할 경우, 장애 발생 시 데이터 손실, 확장성 문제, 일관성 저하 등의 문제를 겪을 수 있습니다.
Redis를 보다 안정적이고 확장 가능하며 고가용성있게 설계를 할 수 있습니다.
* Redis Replication
Master-Slave 구조를 기반으로 작동하며, 데이터를 여러 노드에 복제하여 가용성과 성능을 향상
Master 노드가 모든 쓰기 연산을 처리하고, Slave 노드: Master 노드의 데이터를 복제하여 읽기 연산을 분산
복제를 하여서 여러개의 Slave 노드를 통하여 읽기 부하를 분산시킨다.
Master노드가 변경되면 모든 Slave 노드는 해당 변경사항을 반영한다. 또한 Slave노드를 활용하여 Master 데이터에 대한 손실을 방지한다.
✔ 특징 : 비동기복제가 이루어진다 (Master는 Slave의 응답을 기다리지 않고 데이터를 전송)
Slave노드에서 GET 요청을 통하여 읽기 요청의 부하를 분산시킨다.
✔ 단점 : 비동기 방식이라 Slave가 최신 데이터를 반영하는 데 시간이 걸릴 수 있음
Slave는 Master의 데이터를 동기화해야 하기 때문에, Slave가 많아지면 Master의 CPU/메모리 사용량이 증가
* Sentinel
Master, Slave, Sentinel(일반노드들을 모니터링) 노드로 구성됨.
Redis Master-Slave 복제(Replication) 환경에서 Master 장애 시 자동으로 Slave를 승격하여 시스템을 유지하는 방식이다. 복제 환경에서 장애 조치를 자동화하기 위한 목적으로 사용된다.
1. 지속적인 모니터링으로 마스터노드가 응답이 없으면 장애(Failure)로 인식
2. Slave 노드 중 하나를 마스터로 승격시킨다. 클아이언트가 새로운 Master노드를 사용하도록 유도한다.
3. 클라이언트가 Master를 조회할 수 있도록 새로운 Master 정보를 제공
https://develop-actas.tistory.com/67
[Redis] Redis Replication, Sentinel (Spring Boot)
Redis Replication은 하나의 Redis 서버(마스터)가 여러 개의 복제 서버(슬레이브)에게 데이터를 동기화하는 기능 이를 통해 데이터의 가용성(Availability)과 부하 분산(Load Balancing) 효과를 얻을 수 있습
develop-actas.tistory.com