[Spring Batch] 대용량 데이터의 처리
유튜브를 보다가 우연히 카카오에서 올린 1억건 데이터 처리를 위한 노력이라는 영상을 봤다.
생각없이 보다가 아주 유용한 정보 인듯 하여 정리해서 기록 하여 놓아야 겠다.
주제는 주로 Batch 작업을 하면서 대용량 데이터에 대한 성능처리였다.
핵심만을 정리하여 말하자면
1. Reader 개선
보통 조회시에 10만개의 데이터가 있을때 10만개를 다 가져온다면 그나마 덜 부담스러울 것이다.
하지만 복잡한 조회조건도 있을 수 있고, 어떠한 서비스는 1억개가 넘는 데이터가 있을 수 있다.
여기서 쿼리를 튜닝해주는 것만으로도 엄청난 효과를 가져온다.
주요 개념
✔ Batch Chunk Processing : (얼마나 읽고, 얼마나 저장할지)
Spring Batch가 데이터를 처리하는 전략 , 데이터를 일정 단위(chunks)로 묶어서 읽고, 처리하고, 저장
✔ Pagination ( 어떻게 읽느냐 )
데이터를 offset/limit 방식으로 쪼개서 읽음
🔘 한 번에 필요한 만큼만 읽음 (메모리 안정)
🔘 offset이 커지면 성능 하락 가능
✔ Cursor ( 어떻게 읽느냐 )
DB 커서를 열어두고, 하나씩 또는 streaming 방식으로 계속 읽음
데이터를 모두 읽고 서버에서 직접 커서하는 방식이라서 OOM 유발, 사용을 자제하는 것을 추천한다.
DB에서 데이터를 "하나씩" 읽어오는 방식인데, 이게 JPA 내부적으로 커서를 열고 엔티티를 영속성 컨텍스트에 계속 쌓아두는 방식이라서…
데이터를 너무 많이 읽으면
메모리에 계속 객체가 쌓이고
결국 JVM 메모리가 꽉 차서 내부적으로는 쌓이는 구조라서 메모리 폭탄이 된다.
그러면 해결방법은 ?
1. MySQL의 Cursor를 사용하여 일정 개수만큼 끊어서 처리하는 JdbcCursorItemReader 혹은 HibernateCursorItemReader 사용
- 단점 : 쿼리를 문자열 자체로 날려야 해서 뭔가 우아하지 않을 수 있다 (객체지향적이지 않다, DB에 의존적이다).
2. JetBrains Kotlin 기반의 ORM 프레임워크 Exposed 사용
이 방법은 내가 Kotlin에 대해 공부를 해본적이 없어서 유심히 보지는 않았다. 나중에 다시 알아보도록 해야겠다.
자바에서는 호환이 안된다고 한다.
알아보고싶다면 아래 링크에서 청취하기 바란다.
https://www.youtube.com/watch?v=2IIwQDIi3ys
3. ZeroOffsetItemReader
가장 관심있게 본 방법이다. 이것은 Pagination 방식 사용시에 문제점인 offset이 커질 경우 성능저하에 대하여 해결하고 있다. ZeroOffsetItemReader는 이런 offset 사용을 피하고,
대신 "마지막으로 읽은 키(ID 등)"를 기준으로 다음 페이지를 이어서 가져온다.
ex : select * from orders where category = 'BOOK' and id > 0 limi 0, 100; --마지막 행의 아이다깂이 5235
select * from orders where category = 'BOOK' and id > 5235 limi 0, 100;
성능비교
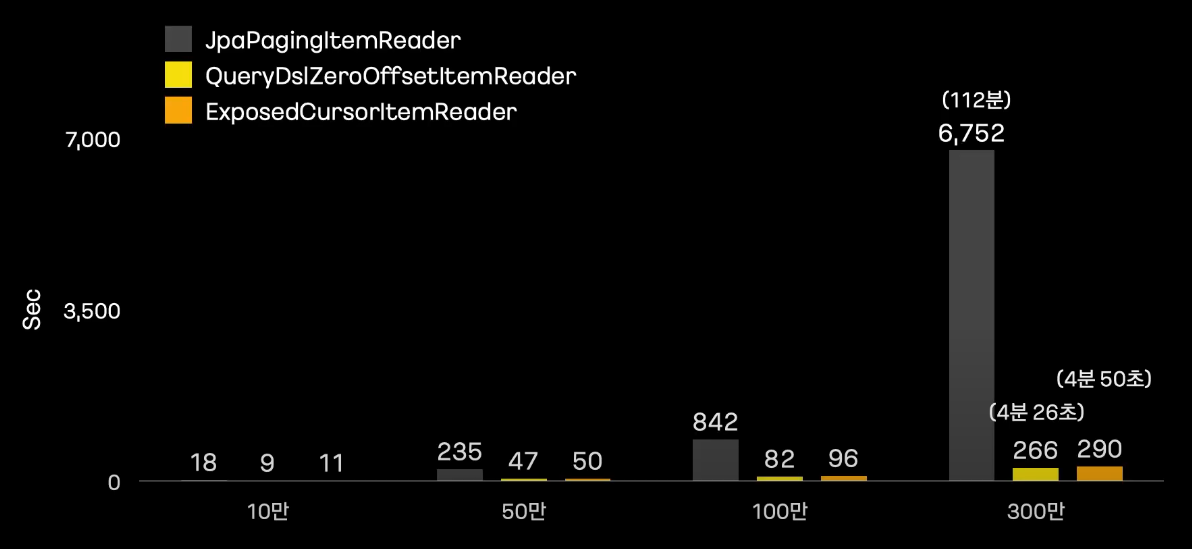
해당 성능비교표를 보면 압도적인 차이가 나는것을 볼 수 있다.
특히 JpaPaging 방식은 offset이 커질수록 (x값이 상승) 비례적으로 상승하는 것도 아니다.
100만 -> 300만으로 갈때 3배보다도 많은 배수의 시간이 걸렸다.
| JpaPagingItemReader | JdbcCursorItemReader | JpaCursorItemReader | QueryDslZeroOffset | |
| 쿼리 구현 | QueryDSL JPQL QueryMehtod |
네이티브쿼리 | JPQL | QueryDSL |
| 동작 | offset 사용 | Cursor 방식 | 서버에서 직접 Cursor처리 | OffSet 항상 0으로 유지 PK를 조건절에서 활용하는 방식 |
| 성능 | 조회할 데이터가 많으면 현저히 느려 | FetchSize와 DB설정만 제대로 잡아주면 조회 속도가 빠르다. | 성능은 좋지만 메모리 관리가 힘들다. (OOM) |
첫 페이지 읽는것처럼 동일하게 항상 일관된 조회 가능하다. |
2. Aggregation 처리
일정기간의 통계를 위해 배치처리를 할때 Reader에서 그룹화를 통하여 Sum 쿼리를 날린다.
해당 합산금액을 저장한다
이러한 방식의 처리는 데이터가 적고 쿼리가 무난하다면 합리적일 수 있다.
join + GroupBy + sum 쿼리의 문제점으로 발표자는 다음과 같이 얘기하고 있다.
1. 연산이 쿼리에 의존적이다 -> DB 부하가 증가한다.
2. 데이터가 누적됨으로써 카디널리티가 변경되고 쿼리튜닝이 어려워진다.
3. 과도한 인덱스를 추가함으로써 IO작업에서의 성능이 저하된다.
저러한 쿼리로 인해 1번에서한 성능개선이 무용지물이 될 수 있다고 한다.
발표자는 그룹화를 포기하고 직접 Aggregation을 하고자 하는 방향으로 잡는다.
하지만 직접한다하면 데이터가 100만개일때 직접 100만개를 가지고 있으면서 처리한다? --> 메모리부족해서 불가능
Redis활용
1.1000만개의 데이터가 존재한다 할때, 1000개씩 분할하여 1만개의 청크로 나눈다.
2. Redis를 통하여 청크에 대한 sum 연산을 요청한다.
3. 반복합산하면 최종적으로 50만개의 SUM 데이터가 Redis에 존재 -> 데이터저장소에 저장
이렇게 시나리오가 만들어 질 수 있다.
Redis의 사용이유
- 메모리 수준에서의 빠른 합산
- 넉넉한 메모리를 가지고 중간결과는 영구 저장할 필요도 없고 인메모리 방식으로 빠른 저장이 가능하다.
문제 발생 : 하지만 그래도 1000만번 SUM 요청을 하는것은 변함 없다. -> 1000만번의 오버헤드 발생한다.
한번의 네트워크 비용은 별로 안들지만 물리적으로 데이터가 많으면 결과론적으로는 네트워크비용이 많아질수밖에 없다.
Redis Pipeline (다수의 Command를 한번에 묶어서처리, 하나의 청크로 연산처리)을 통하여 1만번 요청으로 줄일 수 있다.
해당 파이프라인은 카카오측에서 별도로 라이브러리로 개발하여 사용중인듯 하다. (Redis에서 지원하지 않는다.)
3. Writer 처리 개선
크게 두개의 대전제가 있다.
1. Batch Insert : 일괄로 IO작업
2. 명시적 쿼리 : 영속성 컨텍스트 사용하지 말자(Jpa x) 필요한 컬럼만 업데이트
jpa가 batch 작업과 어울리지 않는이유
✔ Dirty Checking과 영속성관리 : 복잡한 JPA 기능들이 필요하지 않다.
- JPA는 엔티티의 상태 변화를 추적해서, 트랜잭션 커밋 시 자동으로 update를 실행함.
- 하지만 배치 작업은 단순 insert/update를 매우 많이 수행하고, 변경 감지를 하지 않아도 되는 경우가 대부
- 즉, 불필요한 오버헤드가 발생
- JPA는 영속 상태로 엔티티를 계속 1차 캐시에 유지 --> OOM 발생원인
✔ 모든 컬럼에 대한 UPDATE 작업.
- PA는 기본적으로 변경된 필드만 UPDATE하지 않고, 모든 필드에 대해 UPDATE 쿼리
- @DynamicUpdate도 좋은방법은 아니다. 동적 쿼리의 생성을 위해 어떤 필드가 변경되었는지 추적해야함
- 즉, 하이버네이트는 변경 전 상태를 저장하고, flush 시에 비교하여 변경여부를 판단
- 이렇게 되면 더티체킹이 들어가게 되고 영속성 컨텍스트가 복잡해진다.
✔ JPA사상과 Batch Insert랑 맞지 않음 : ORM 중심의 개별 엔티티 관리와 영속성 유지에 맞춰져 있기 때문
- 배치 시 수천 개의 객체가 메모리에 누적되며 OutOfMemory 위험
- ID 생성 전략이 자동 증가(AUTO_INCREMENT)**이면, JPA의 Batch Insert 사용이 어려움.
- INSERT 전에는 ID를 알 수 없기 때문에 여러 개를 한 번에 batch로 묶어 보낼 수 없음
Batch작업에서의 현황 모니터링 및 측정
위와 같은 작업에 Spring Cloud Data Flow(SCDF)를 추천해준다.
데이터 수집, 분석, 데이터 입출력과 같은 데이터 파이프라인을 만들고 오케스트레이션해주는 툴이라고 한다
SCDF는 Spring Batch로 작성된 Job을 컨테이너화해서 실행
Job을 파이프라인처럼 구성 가능
- Step1 → Step2 → Step3 순차 흐름
- 혹은 if-else, split, parallel 등 다양한 흐름 제어 가능
* SCDF에서 데이터 흐름(Flow)를 시각적으로 구성할 수 있음
SCDF는 배치 작업을 cron 주기로 등록할 수도 있고, 실행 상태 모니터링도 UI가 제공된다.
배포/운영/모니터링을 SCDF가 알아서 해준다.
출처 : https://www.youtube.com/watch?v=2IIwQDIi3ys