[스레드와 멀티스레딩]
프로세스를 실행 단위로 멀티태스킹을 하였을때의 문제점
1. 프로세스 생성의 많은 비용이 소모된다.
PCB를 생성하고, 메모리를 할당하고 부모프로세스로부터 복사 하는 일련의 과정들이 오버헤드가 크다.
2. 문맥교환(컨텍스트 스위칭)시에 많은 비용이 소모된다.
3. 프로세스 끼리의 통신
프로세스가 직접적으로 다른 프로세스와의 통신이 쉽지가 않다.
다른 우회적인 방법을 사용해야 하는데 번거롭다. (공유 메모리 OR 네트워크 통신방법 등)
결론적으로 커널에 많은 시간과 공간이 부담되어서 전체적인 속도저하를 불러온다.
이러한 배경으로 나타난 실행 단위가 스레드이다.
- 프로세스보다 크기가 작아 생성 및 소멸이 빠르다
- 컨텍스트 스위칭이 비교적 가볍다
- 통신이 쉽다.
스레드
스레드는 실행단위이며 스케줄링 단위이다.
프로세스 내에서 실행되는 가장 작은 단위의 작업 흐름
코드,데이터, 힙, 스택을 가진 실체이며 프로세스가 PCB를 가지는 것처럼 TCB를 가지고 있다.
프로세스는 스레드들의 컨테이너가 되는 것이다. (프로세스는 반드시 1개 이상의 스레드로 구성된다.)
하나의 프로세스에 속한 스레드들은 프로세스의 자원과 메모리공간을 공유하며 통신이 원할하다.
운영체제 커널에 있는 TCB 리스트로 스케줄링 등을 관리한다.
그래서 이러한 일련의 작업단위인 스레드들 여러개로 관리하며 작업을 병렬적으로 처리가 가능해진다.
웹 브라우저를 예시로
- 각 탭마다 별도의 스레드 혹은 프로세스를 가진다.
- 한탭에서 작업해도 다른탭은 영향을 받지 않는다.
- 이미지 로딩, 사용자 입력 감지 등 각기 다른 스레드가 작업을 담당하여 처리한다.
멀티스레드 관련 개념
✔ Concurrency (동시성)
1개의 CPU에서 2개 이상의 스레드가 동시에 실행 중인 상태이다.
엄밀히 말하면 동시 실행은 아니다 매우 빠르게 일련의 작업들이 타임슬라이스 단위로 교체되면서 실행되어서
동시에 실행되는 것처럼 보일 뿐이다.
✔ Parallelism (병렬성)
2개 이상의 스레드가 다른 CPU에서 같은 시간에 동시 실행되는 상태이다.
이 경우에는 실제로 동시에 실행되는 환경이 구성된다.
스레드 주소 공간
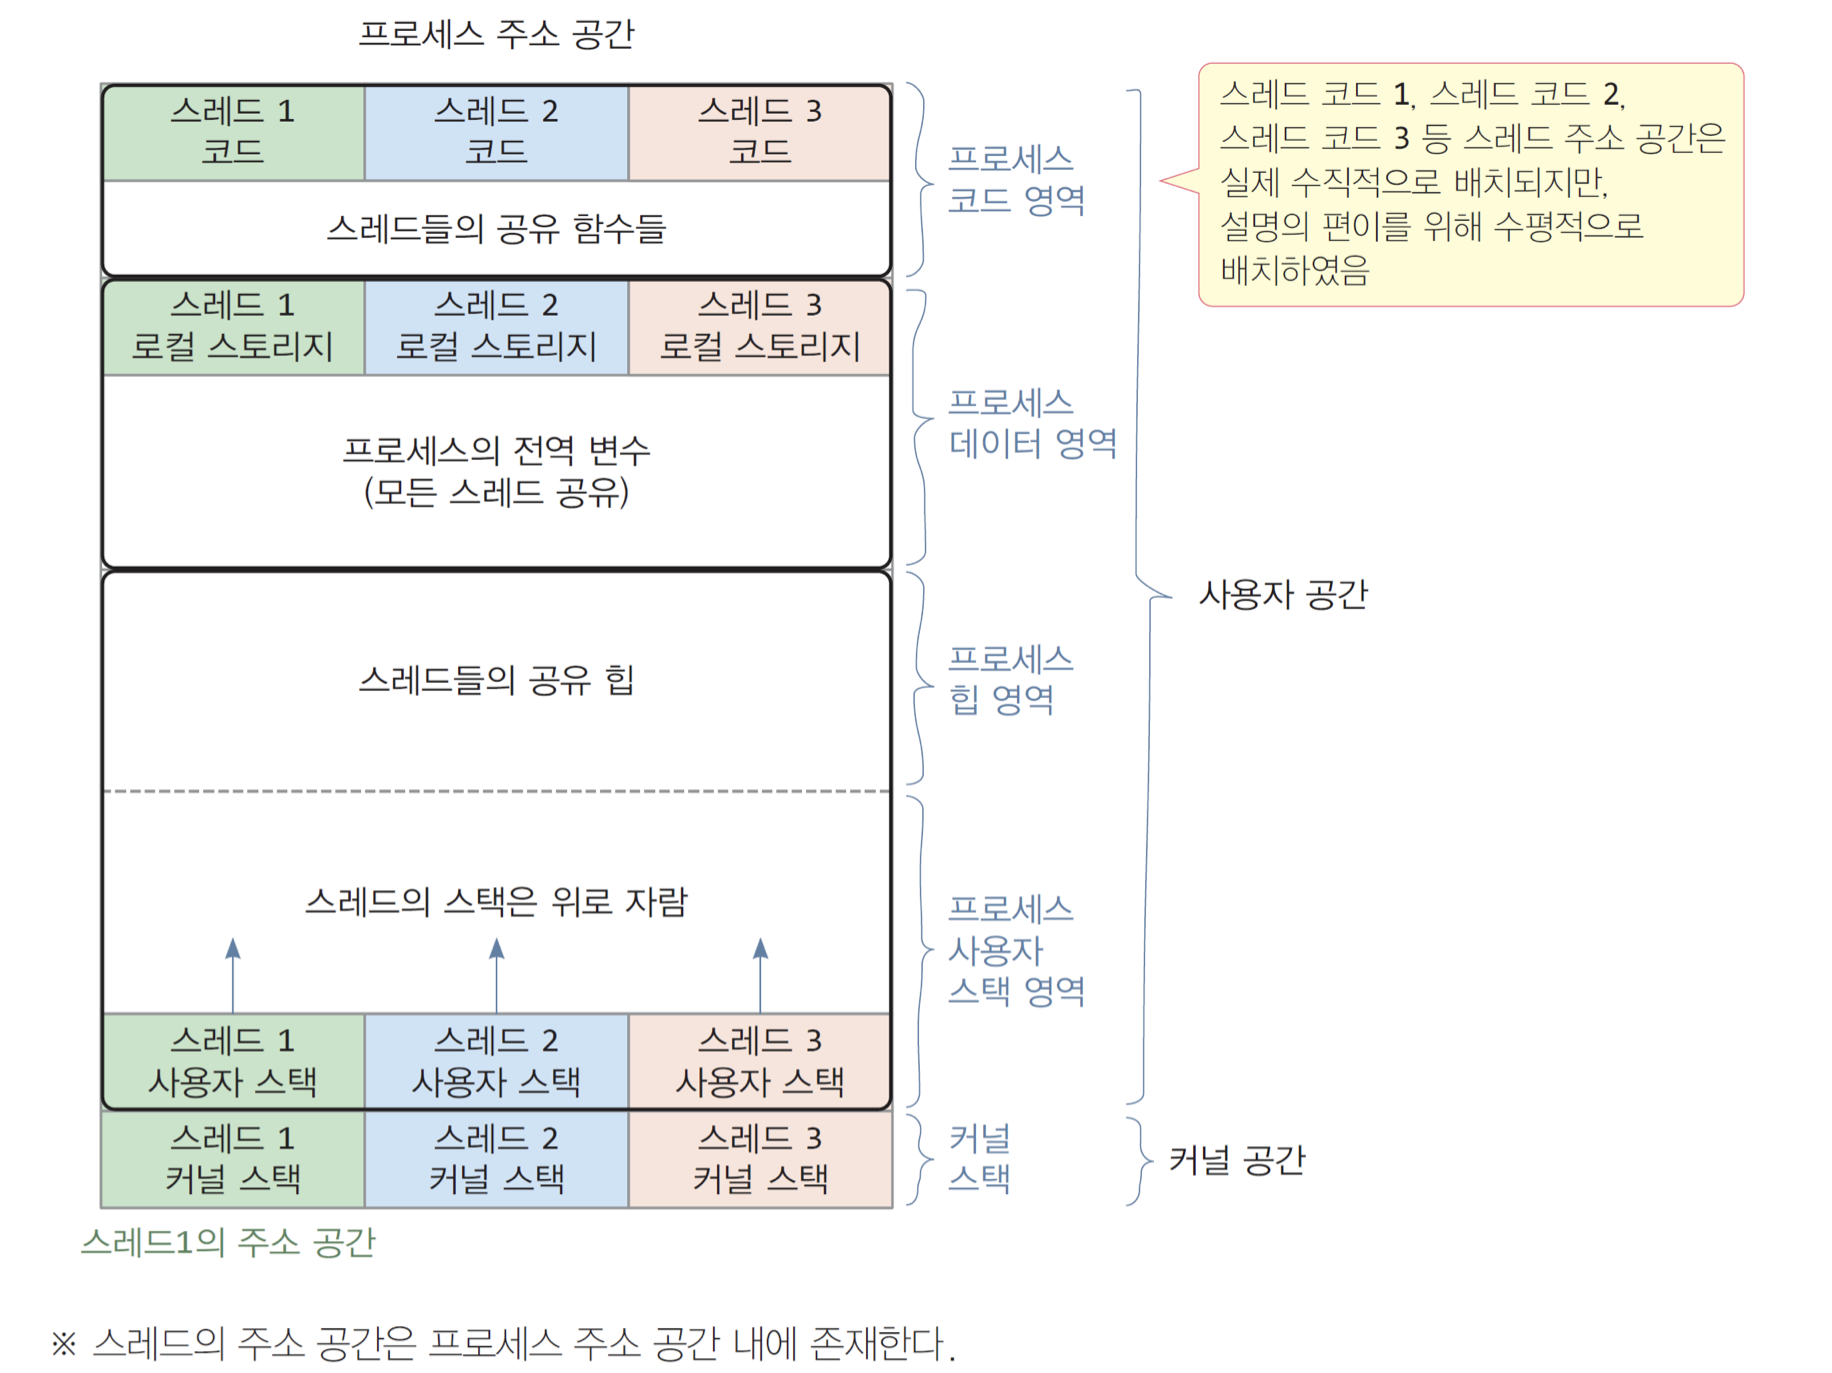
멀티스레드 환경에서는 스레드들이 같은 프로세스 안에서 실행되기 때문에, 어떤 것들은 공유하고, 어떤 것들은 스레드별로 따로 갖고 있다. (공유되는 자원에 있어서는 동기화 작업이 중요하다.)
공유되는 자원들:
✔ 코드 영역 : 실행할 프로그램 코드 (함수, 매서드등)
✔ 데이터 영역: 전역 변수, STATIC 변수
✔ 힙 영역 : 동적 할당된 메모리 (NEW)
공유되지 않는 자원들:
✔ 스택 영역 : 함수 호출 시 사용하는 지역변수, 매개변수 등
✔ 레지스터 상태: CPU 레지스터, 프로그램 카운터 등 스레드의 개인정보
스레드 상태
스레드는 생성, 실행, 중단, 실행, 소멸 등의 여러 단계를 거치면서 실행된다.
스레드의 상태는 TCB에 저장된다.
- 1. New (생성됨)
- 스레드 객체는 생성됐지만, 아직 start()가 호출되지 않음
- 실행 준비 완료!
- CPU가 할당되면 Running 상태로 전환됨
- 어떤 OS에서는 Running과 Runnable을 합쳐서 "Ready"라고 부르기도 해
- CPU를 배정받아서 실제로 코드를 실행 중
- 다른 스레드의 작업이 끝나기를 기다리는 상태
- 예: 락을 잡기 위해 기다리거나, 특정 조건이 만족될 때까지 대기
스레드 컨텍스트
스레드 컨텍스트(Thread Context)**는 한 스레드가 실행되기 위해 필요한 CPU 상태 정보들의 모음
주요 구성 요소
- 프로그램 카운터 (PC): 지금 실행 중인 명령어의 주소
- 레지스터 값들: 작업에 필요한 데이터가 들어 있음
- 스택 포인터: 함수 호출 시 사용할 스택의 위치
- 스레드 상태 정보: Runnable, Waiting 등의 상태
이 정보들을 저장/복원하면서 CPU는 여러 스레드를 번갈아 실행
스레드는 같은 메모리를 사용하기 때문에 모밀 관리 구조를 바꿀 필요가 없지만
프로세스 간 전환은 OS가 메모리 맵 전체를 바꿔서 소모가 많이 든다.
스레드 시위칭이 발생하는 경우들
✔ 스레드가 자발적으로 다른 스레드에게 실행을 양보
- yield() 등의 시스템 호출을 통하여
✔ 스레드가 시스템 호출을 실행하여 블록되는 경우
- read, sleep, wait 등 io가 발생하거나 대기할 수 밖에 없는 경우
✔ 스레드의 타임 슬라이스를 소진한 경우
✔ io장치로부터 인터럽스 신호가 발생한 경우
이외에도 여러가지 이유로 문맥교환이 일어남
스레드 스케줄링 주체에 따라 2종류의 스레드로 구분된다.
사용자 레벨 스레드 (User-Level Thread, ULT)
- 운영체제가 아닌 사용자 공간에서 스레드 관리
- 스레드 생성, 스케줄링, 컨텍스트 스위칭 등을 라이브러리 수준에서 처리
장점
- 빠름: 커널 개입이 없어 컨텍스트 스위칭이 매우 가볍다
- 이식성 높음: 어떤 OS에서도 동작 가능 (OS가 스레드 인식 못 해도 됨)
단점
- 커널은 스레드를 모름 → 하나의 스레드가 블록되면 전체가 멈춤
- 진짜 CPU 병렬 실행은 불가능 (커널 입장에선 하나의 실행 흐름)
커널 레벨 스레드 (Kernel-Level Thread, KLT)
특징
- 스레드를 운영체제 커널이 직접 관리
- 각 스레드는 커널이 인식하며, CPU 스케줄러가 직접 분배함
- 예: Linux (POSIX pthread), Windows Thread 등
장점
- 진짜 병렬 처리 가능 (멀티코어에서 각 스레드가 동시에 실행될 수 있음)
- 한 스레드가 블록돼도 다른 스레드는 실행 가능
단점
- 스레드 전환 비용이 큼 (시스템 콜 → 커널 개입 → 오버헤드)
- 생성, 소멸, 스위칭에 시간이 더 걸림
순수 커널 레벨 스레드라는 것도 있다.
순수 커널 레벨 스레드 (Pure Kernel-Level Thread, PKLT)
우리가 짠 코드가 아닌 이미 짜여저 있고 정해져 있는
부팅때부터 커널의 기능을 돕기 위해 만들어진 스레드이다.
커널 코드를 실행하는 커널 자체의 스레드 인 것이다.
커널 모드에서 작동하고 사용자 모드에서 실행되는 일은 없다.
멀티스레드의 구현
일반적으로 3가지 방법이 있다.
1. N:1 매핑 --> N개의 사용자 레벨 스레드를 1개의 커널 스레드로 매핑
- 모든 프로세스를 단일 스레드 프로세스로 다룬다.
- 커널은 프로세스 당 1개의 커널 레벨 스레드(TCB) 생성
- 스레드 라이브러리에 의해 스케줄링 된다. (커널은 관여하지 않는다)
-장점 :
단일 코어 CPU에서 멀티스레드 응용프로그램의 실행속도가 전반적으로 빠르다.(커널에 진입이 없으므로)
-단점 :
멀티코어 CPU가 보편화된 현대 컴퓨터입장에는 비효율적이다.
(프로세스에 속한 여러 사용자 레벨 스레드들의 병렬처리가 불가능하다.)
하나의 사용자 레벨 스레드가 다운되면 프로세스가 전체적으로 다운되버림.
2. 1:1 매핑 --> 1개의 사용자 레벨 스레드를 1개의 커널 스레드로 매핑
- 사용자 레벨 스레드 당 1개의 커널 스레드 생성
-사용자 스레드는 커널 스레드가 스케줄링될때 실행된다.
-장점 :
멀티코어 CPU에서 멀티스레드 응용프로그램에게 병렬작업을 제공
사용자 스레드가 하나 다운되어도 전체가 다운되지는 않음
-단점 :
커널에게는 부담스러운 작업이 될것.
3. N:M 매핑 --> N개의 사용자 레벨 스레드를 M개의 커널 레벨 스레드로 매핑
- N개의 사용자 레벨 스레드를 M개의 커널 레벨 스레드에 매핑
1:1에 비해서는 매핑되는 커널 스레드 갯수가 작아 덜 부담스럽지만.
구현하기 복잡하여 거의 사용하지 않는다.