[JAVA] JVM 역할 및 내부구조
자바로 작성된 파일을 어떻게 컴퓨터가 실행 할 수 있을까?
자바는 플랫폼에 독립적으로 운용이 가능하다는데 그 원리는 무엇일까?
이러한 물음에 답하기 전에 몇몇 개념들이 필요한데 알아볼 필요가 있다.
* 인터프리터 언어
인터프리터 언어는 고급언어로 작성된 코드를 실시간으로 프로그램에 의해서
저급언어로 변환하여 실행되는 언어를 말한다.
소스 코드를 한 줄씩 해석하며 즉시 실행하는 방식이며 실행파일을 생성하지 않는다.
* 컴파일러 언어
컴파일 언어는 인간이 이해가능한 고급언어로 작성한 코드를 가지고 있다가
한번에 컴퓨터가 이해가능한 저급언어로 변환하는 과정을 말한다.
사전에 전체 소스 코드를 한 번에 기계어로 변환(컴파일)하여 실행 파일을 생성하고, 이 파일을 실행하는 방식
자바는 컴파일러 방식과 인터프리터 방식을 모두 채택하여 혼합된 형식으로 사용하고 있다.
자바코드로 작성된 파일을 실행하기 위해서는 아래와 같이 과정이 필요하다.
1. 자바언어로 코드 작성
2. javac(Java Compiler)를 사용해 .java 파일을 바이트코드로 컴파일하여 .class 확장자를 가지는 바이트코드 파일 생성 , 바이트코드는 사람이 보기 어렵지만, JVM이 이해할 수 있는 중간 형태의 코드
3. ClassLoader는 클래스들을 로딩하여 Runtime Data Area에 올린다.
4. Runtime Data Area에 로딩된 바이트 코드는 Execution Engine을 통해 실행된다.
그럼 JVM이라는 애는 뭐하는 애인가?
JVM (java virtual machine)
자바 프로그램이 실행되는 가상 컴퓨터(가상 머신). 자바 컴파일러가 생성한 **바이트코드(.class 파일)**를 받아, 이를 운영체제에 맞는 기계어로 변환하여 실행해주는 역할
자바컴파일러는 자바 소스 코드를 바이트코드(.class)로 변환한다.
JVM은 이 바이트코드를 읽고 실행합니다. 실행 방식에는 한줄씩 해석하며 실행하는 인터프리터 방식과
바이트코드를 기계어로 변환하여 캐싱하고 빠르게 실행하는 방식인 JIT컴파일러 방식이 있습니다.
JVM은 특정 OS에 맞게 빌드되어 제공됩니다.
따라서, 바이트코드는 플랫폼 독립적이지만, JVM은 플랫폼 종속적이다.
JVM은 Java SE 사양에 따라 정의된 스펙만 제공하고 다양한 회사(벤더)에서 이 명세를 구현한 JVM을 제공하기 때문에 유연한 동작이 가능하다.
그래서 우리가 자바코드를 실행하기전에 JDK를 받아서 우리 컴퓨터 OS에 맞는 JVM을 설치하는 것이 중요합니다.
* JIT 컴파일러란?
자바의 바이트코드는 인터프리터 방식으로 코드를 즉시 읽어서 동작한다.
이러한 방식의 보완을 위해, 초기실행때 자주 사용되는 바이트 코드를 미리 기계어로 해석하여 캐싱을 통하여 재사용하는 방식이다.
JIT 컴파일러는 같은 코드를 매번 해석하지 않고, 실행할 때 컴파일을 하면서 해당 코드를 캐싱 한다. 이후에는 바뀐 부분만 컴파일하고 나머지는 캐싱된 코드를 사용
* 자바는 컴파일 방식의 언어가 아닌가?
컴파일 방식 + 인터프리터 방식을 혼합한 하이브리드 방식이다.
- .java 파일은 javac 컴파일러에 의해 .class 바이트코드로 변환 --> 컴파일 방식
- 하지만 OS에서 직접 실행되는 바이너리를 만들지 않고 .class 바이트코드를 JVM이 인터프리터로 한 줄씩 읽어 실행하거나,
성능 향상을 위해 JIT 컴파일러가 자주 쓰이는 코드를 미리 기계어로 바꿔 캐싱
그러므로 해당 OS에 맞는 JRE가 설치되어 있어야 한다.
이것을 통해 자바는 OS에 종속되지 않고 개발이 가능해진다.
기존 C언어는 컴파일한 결과물인 .exe 실행파일은 특정 OS나 CPU 구조에 맞춰진 컴파일러에 의해 다르게 컴파일이 되지만
자바는 JVM을 통하여 바이트코드를 해당 OS에 맞게 상호작용하며 실행함으로써 독립적인 실행이 가능하다.
바이트 코드 : 가상머신이 이해할 수 있는 중간 레벨로 컴파일 한 것 바이너리 코드와 달리 어떠한 환경에 종속적이지 않고 실행가능하다.
JRE(자바 런타임 환경, Java Runtime Environment ) : JVM + JAVA 라이브러리
JVM과 핵심 라이브러리(java.lang, java.util 등) 및 자바 런타임 환경에 사용되는 설정값과 리소스를 가지고 있다.
그 밖에도 폰트, 로컬라이징 메시지, 네이티브 라이브러리 등의 jar파일도 포함하고 있다.
요즘에는 기본적으로 JDK 안에 포함되어 있다.
JDK (Java Development Kit)
JRE + 자바 컴파일러 및 자바 개발 도구
개발자들이 자바로 개발하는 데 사용되는 SDK 키트
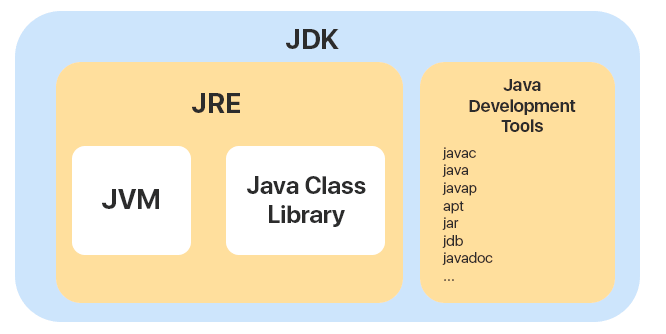
이런듯 실행에 중요한 역할을 하는 JVM의 과정과 개념을 간략히 알아 보았다. 근데 JVM은 더욱 세밀하게 알아볼 필요가 있다.
JVM의 내부 구조
* JVM 내부 구조는 아래 블로그에서 참조하여 공부를 하였다. 아래 블로그가 정리가 잘되어있다.
☕ JVM 내부 구조 & 메모리 영역 💯 총정리
저번 포스팅에서는 JRE / JDK / JVM에 대해서 간략하게 알아보는 시간을 가졌다면, 이번 포스팅에서는 JVM의 내부 구조에 대해 좀 더 자세하게 알아보도록 할 예정이다. JVM(자바 가상 머신)은 자바 언
inpa.tistory.com
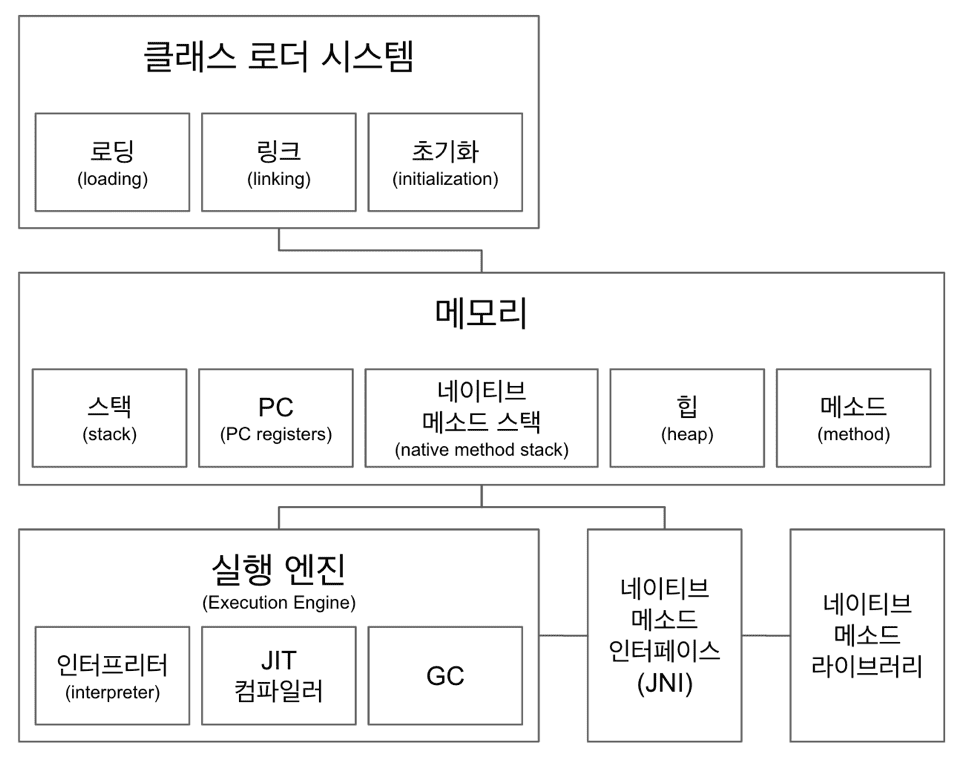
위 그림과 같이 JVM 구성은 아래와 같이 구성되어 있다.
* 클래스 로더
* 실행 엔진 (인터프리터, JIT 컴파일러, GC)
* Runtime Data Area
* 네이티브 메서드 인터페이스 (JNI)
* 네이티브 메서드 라이브러리
같이 하나하나 뭐 하는 애들인지 살펴보자.
1. 클래스 로더 (Class Loader)
자바 프로그램 실행 시, .class 파일을 JVM 메모리로 로드하고 정의하는 핵심 구성 요소
자바 바이트코드를 JVM이 이해할 수 있는 형태로 로딩해주는 역할
즉, 로드된 바이트코드들을 JVM 메모리 영역인 Runtime Data Areas에 배치한다.
클래스 로더의 역할
✔️ 클래스 로딩 : .class파일을 바이너리로 읽어 메모리에 적재
✔️ 클래스 링크 : 클래스 간 참조 관계를 해석하고 검증
✔️ 클래스 초기화 : static 필드 초기화, static 블록 실행 등
클래스 로딩 과정
1. Loading (로드) : 클래스 이름을 기반으로 .class파일을 찾은 후 해당 파일을 읽어 JVM 메모리 영역에 로드한다.
2. Linking : 클래스파일들을 검증하는 과정
Verifying(검증) : 읽어들인 클래스가 JVM 명세에 명시된 대로 구성되어 있는지 검사한다.
preparing(준비) : static 필드들을 기본값으로 할당한다. (0 , null )
Resolving(분석) : 클래스, 인터페이스, 필드, 메서드 참조를 실제 메모리 주소로 변환
3. Initialization : static 변수에 코드 기반 초기값 할당
2. 실행 엔진 (Execution Engine)
JVM 메모리에 로드된 바이트코드를 실제로 실행하는 컴포넌트
즉, .class 파일이 메모리에 올라오면, 실행 엔진이 그 바이트코드를 해석하거나 컴파일하여 기계어로 변환하고 실행.
인터프리터
바이트 코드 명령어를 하나씩 읽어서 해석하고 바로 실행한다.
JVM안에서 바이트코드는 기본적으로 인터프리터 방식으로 동작한다.
JIT 컴파일러
자주 실행되는 코드(핫스팟)를 기계어로 변환하고 더 이상 인터프리팅 하지 않고 캐싱해 두었다가 네이티브 코드로 직접 실행한다.
가비지 컬렉터
Heap 메모리 영역에서 더는 사용하지 않는 메모리를 자동으로 회수
3. 런타임 데이터 영역 (Runtime Data Area)
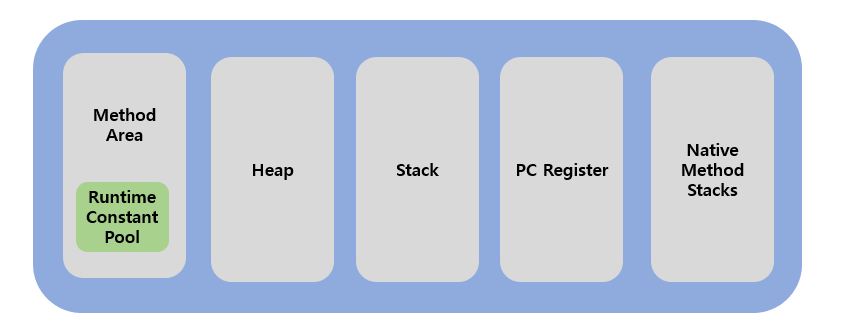
런타임 영역은 JVM의 메모리 영역으로, 자바 애플리케이션이 실행되면서 사용되는 데이터들의 창고 같은 개념이다.
Method Area, Heap 영역은 모든 쓰레드가 공유하는 공유 영역이고,
Stack, PC Register, Native Method Stacks 는 Thread Local 하게 각 쓰레드마다 생성되는 개별 영역이다.
* 메서드 영역 (Method Area)
클래스 정보, static 변수, 메서드 정보 저장하는 영역이다.
* 힙 영역 (Heap Area)
new로 생성된 객체가 저장됨 (가비지 컬렉터의 대상) 및 Reference Type이 저장되는 곳이다.
힙 영역에 생성된 객체와 배열은 Reference Type으로 스택영역의 참조변수나 다른 객체의 필드에서 참조된다.
힙의 참조 주소는 "스택"이 가지며 해당 참조를 통해서만 힙 영역에 접근이 가능하다.
* 스택 영역 (Stack)
자바의 기본 자료형을 생성할때 저장하는 공간이며, 임시적으로 사용되는 변수나 정보들이 저장된다.
메서드 호출시 각각의 스택 프레임이 생성되고 그 메서드 안에서 사용되는 값들을 저장하고,
메서드 호출 시 사용되는 지역 변수, 매개변수, 리턴값, 연산 스택 등 저장. 스레드마다 생성
메서드 수행이 끝나면 프레임별로 삭제된다.
* PC 레지스터
각 스레드가 현재 실행 중인 바이트코드 명령의 주소 저장 (Program Counter)
CPU 내에 있는 레지스터라고 생각하면 된다.
하지만 자바는 하나의 프로세스에 지나지 않기 때문에 가상머신의 리소스를 사용해야 한다.
그래서 직접 CPU에서 처리하는 것이 아닌, 현재 작업하는 내용을 CPU에게 연산으로 제공해야 하며,
이를 위한 저장 공간으로 사용된다.
그런데 만약 자바가 아닌 다른 언어가 실행된다면 내부 값은 undefined 가 된다. 이 undefined 값은 Native Method Stack 공간과 관련이 있다.
* 네이티브 메서드 스택 (Navtive Method Stack)
JNI를 통해 호출되는 외부 C, C++ 라이브러리용 스택
JIT 컴파일러를 통해 산출된 네이티브 코드 변환 과정은 JVM 내부에서 처리하며 자체적으로 메모리에서 관리하고
Native Method Stack은 JNI 호출용 (외부 C/C++ 네이티브 코드 실행용) 이다.
* Native Method Library
자바가 JNI를 통해 호출하는 C, C++ 등의 네이티브(기계어) 코드가 들어 있는 외부 라이브러리 파일
JVM이 직접 실행할 수 없지만,
JNI (Java Native Interface) 를 통해 자바 코드에서 해당 라이브러리의 함수나 기능을 사용할 수 있게해준다.
| Windows | .dll (Dynamic Link Library) | 예: native-code.dll |
| Linux | .so (Shared Object) | 예: libnative.so |
| macOS | .dylib | 예: libnative.dylib |
이런 파일들이 네이티브 메서드 라이브러리이다.
예시 :
public class Hello {
    static {
        System.loadLibrary("hello");
    }

    public native void sayHello();
}
#include <jni.h>
#include <stdio.h>
#include "Hello.h"

JNIEXPORT void JNICALL Java_Hello_sayHello(JNIEnv *env, jobject obj) {
    printf("Hello from native C code!\n");
}
해당 실행으로 C언어로 작성된 파일들이 실행된다.