Batch
일괄 처리를 위한 오픈 소스 프레임워크이다.
일반적으로 대량의 데이터를 처리하거나, 주기적이며 반복적인 작업과 주기가 정해진 작업을 진행하는 프레임워크이다.
- 정해진 시간에 작업
- 정산 작업
- 통계 데이터 구축
- 대량의 데이터 핸들
스프링 배치의 사용으로 인한 장점
1. 대량의 데이터를 효율적으로 처리할 수 있다.
2. 자동 재시작 및 오류 복구가 용이하다. (실패한 배치를 특정 지점부터 재시작)
3. 트랜잭션 관리 (각 단계별 트랜잭션 관리, 롤백에 용이)
4. 배치 작업의 모니터링 및 로깅 관리
* 안정적으로 대규모 데이터 처리가 용이하며, 장애 발생시 대응이 용이하다.
배치의 주요 구성요소
1. Step (작업단위) / Tasklet 기반
배치 처리를 정의하고 제어하는 독립된 작업의 단위
ex: 알람 전송 전에 누구할때 보낼지 선택하는 step, 알람을 발송하는 step
● Step에서 실행될 간단히 정의한 하나의 작업 처리 (단일 작업) , ex: 정의된 알람 전송, 노후된 데이터 삭제
● 한번만 실행되고 종료된다.
2. Step (작업단위) / chunk 기반
배치 처리를 정의하고, 제어하는 독립된 작업단위
● Step에서 대량 데이터를 효율적으로 처리
● 데이터 읽기를 반복하여 처리후 한번에 저장하는 방식
● ItemReader → ItemProcessor → ItemWriter 구조
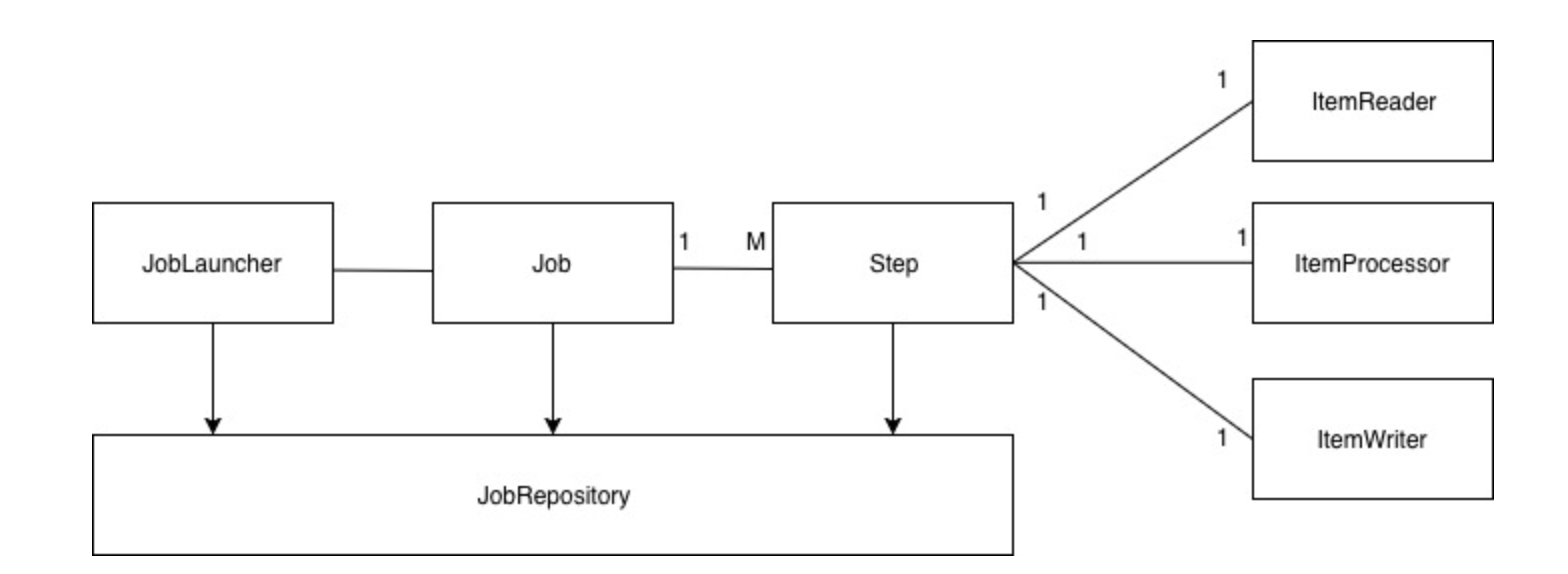
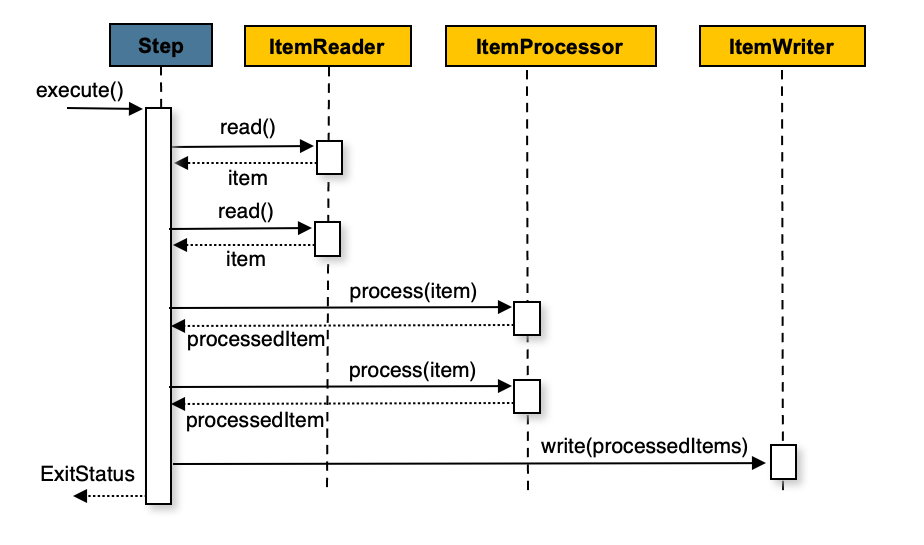
itemProcessor은 필수 구성이 아니다.
itemReader : 파일, DB, 큐 등에서 데이터를 읽어온다.
itemProcessor : 읽은 데이터를 가공 및 필터링 , 변환 한다.
itemWriter : 처리된 데이터를 DB, 파일 등에 저장한다.
- Step 에서 ItemReader를 통해 chunk단위로 처리할 아이템을 반복해서 얻어온다.
- Processor가 있다면 역시 마찬가지로 반복적으로 Proceesor에 대한 처리가 이루어진다.
- 작업이 완료되면 아이템을 한번에 모아서 ItemWriter로 전송 하여 쓰기 작업이 이루어진다.
3. Job
외부의존성에 영향을 받지않으며, 고유하고 순서가 지정된 여러 스텝들의 모음이다.
JobLauncher를 통해 실행된다.
배치처리 과정을 하나의 단위로 만들어 놓는 객체이다.
4. JobInstance
Job + JobParameters의 조합으로 정의된 고유한 실행 단위
한 JobInstance는 여러 번 실패했다가 재시작할 수 있음
5. JobParameters
job이 실행시 전달되는 매개변수이다.
이 값에 따라 실행되는 JobInstance가 달라집니다.
JobParameters가 다르면 새로운 JobInstance가 생성됨
JobParameters가 같으면 기존 JobInstance를 다시 사용 (재시작)
같은 JobParameters로 실행하면 같은 JobInstance로 인식되어 재실행이 안 됩니다
- JobParameters = 어떤 문서인지와 몇 부 인쇄할지 등의 명령
- JobInstance = “2025년 6월 12일, 보고서 3부 출력”이라는 특정 실행 작업
| JobParameters | Job 실행 시 전달하는 입력값 세트 |
| JobInstance | Job 이름 + JobParameters 로 구성된 고유한 작업 단위 |
| 같은 JobParameters로 다시 실행 | 기존 JobInstance의 재시작 |
| 다른 JobParameters로 실행 | 새로운 JobInstance 생성됨 |
즉, JobInstance가 한 번 실행될 때마다 생성됩니다.
JobExecution 안에서 개별 Step 실행을 추적합니다.
Job (Job 이름)
└─ JobInstance ← JobParameters로 결정됨
├─ JobExecution #1 ← 실제 실행 기록
│ ├─ StepExecution #1
│ └─ StepExecution #2
└─ JobExecution #2 ← 실패 후 재실행 등
├─ StepExecution #1
└─ StepExecution #2
8. executionContext
스프링 배치에서 실행 중 데이터 공유와 재시작 시 상태 복구에 필수적인 역할
JobExecution 또는 StepExecution에 부가적인 상태 정보나 임시 데이터를 저장하는 Map 구조의 저장소입니다.
- Key-Value 쌍으로 데이터 저장
- Job 또는 Step이 재시작될 때 이전 상태를 복원할 수 있게 도와줌
- 실행 중에 다른 컴포넌트와 데이터 공유도 가능
- 파일을 읽을 때 현재 읽은 위치(라인 번호) 저장
- API 요청 시 마지막 처리된 ID 저장
- Step 간에 데이터를 공유
- 재시작 지점 지정 (예: 100번째 라인부터 다시 시작)
* JobRepository : 배치 수행과 관련된 데이터가 있다. (상태, 시간, 읽기 쓰기 횟수 등)
- 일반적으로 RDB(mysql) 사용
<메타데이터 테이블>
1️⃣ BATCH_JOB_INSTANCE
- 실행된 Job의 인스턴스 정보를 저장 (각 배치 작업의 고유 실행 정보)
2️⃣ BATCH_JOB_EXECUTION
- Job 실행 기록 저장 (시작/종료 시간, 상태 등 포함) , 실제기록
3️⃣ BATCH_JOB_EXECUTION_PARAMS
- 실행된 Job에 전달된 파라미터 값을 저장
4️⃣ BATCH_JOB_EXECUTION_CONTEXT
- Job 실행 중에 저장된 컨텍스트 데이터 (임시 상태값 저장)
5️⃣ BATCH_STEP_EXECUTION
- 개별 Step 실행 정보 저장 (Step별 실행 결과, 상태 등 포함)
6️⃣ BATCH_STEP_EXECUTION_CONTEXT
- Step 실행 중 저장된 컨텍스트 데이터 (Step별 임시 상태값 저장)
* JobLauncher : 잡을 실행한다. 잡은 정해진 Step을 실행하게 된다. Step을 실행하며 상태와 로그등을 JobRepository에 기록한다.
청크 기반 처리란?
하나의 Step 안에서,
- 데이터를 한 개씩 읽고 (ItemReader)
- 가공하고 (ItemProcessor, 선택적)
- 일정량(청크 크기) 모아서
- 한 번에 묶어서 저장 (ItemWriter)
주의점할 점 *******
스프링배치에서 무분별한 JPA 사용은 위험하다.
jpa 자체가 대용량 데이터 처리와는 거리가 멀다. 왜냐하면 JPA는 내부적으로 모든 엔티티를 영속성 컨텍스트에 올리기 때문
JpaItemReader 또는 JpaPagingItemReader 사용 시 주의
- Hibernate는 read()를 통해 조회된 모든 엔티티를 **1차 캐시(EntityManager의 Persistence Context)**에 유지함
- 수천/수만 건이 누적되면 결국 메모리 부족 (OutOfMemoryError) 발생
- flush() 또는 clear()를 수동으로 해야 하지만, 이 또한 실수하기 쉬움
대체할 수 있는 대안으로는 주로 JdbcCursorItemReader or JdbcPagingItemReader가 존재한다.
-JdbcCursorItemReader
- 데이터베이스 커서를 열고 한 줄씩 순차적으로 읽음
- 메모리를 거의 쓰지 않고 효율적
장점
- 하나씩 읽기 때문에 메모리 누수 위험 (OOM)이 거의없다.
- 전체 데이터 순차 접근시 매우 빠르다.
단점
- OFFSET/한 페이지 씩 건너뛰기가 불가능함
- 커서는 동시 접근에 제약이 있다 --> Thread-safe 하지 못한다.
- 커서가 끝날때 까지 커넥션이 물려있어 커넥션 풀 고갈위험이 있다.
단일 쓰레드로 대량 데이터를 일괄 처리하거나 데이터 순서 보장이 필요할 때
혹은 병렬처리나 분할이 필요 없는 단순 배치에서 유용하다.
- JdbcPagingItemReader
- OFFSET 기반 또는 키 기반의 페이지 단위 쿼리로 데이터를 읽습니다.
- 페이지별 SQL 쿼리를 실행해서 일정량씩 가져오는 방식입니다.
장점
- pageSize만큼 데이터를 잘라서 읽기 때문에 페이징 지원가능
- 페이지 범위를 나눠 멀티 쓰레드로 처리 가능하다.
- 커넥션을 오래 물지 않아서 트랜잭션 관리에 유리하다.
단점
- 페이지 단위로 읽어 List, 즉 페이지 사이즈가 너무 크면 메모리 부담이 생긴다.
- offset이 클수록 성능이 저하된다.
이유 -> offset은 데이터를 건너뛰어서 가져오는게 아니다
내부적으로 offset 이전의 모든 데이터를 실제로 정렬하고 스캔해야 한다.
SELECT * FROM orders ORDER BY created_at ASC LIMIT 10 OFFSET 100000;
이렇게 있다면 created_at 기준으로 모든 orders를 정렬하고, 그 중 앞의 100000개는 버리고, 다음 10개만 리턴하게 된다.
- 페이징 처리를 위한 고유 정렬 키가 반드시 필요하다
이것에 대해 좀 더 설명하자면 페이징은 순서가 정해져야 정확히 "다음 페이지"를 알 수 있기 때문에 그런것이다.
기본적으로 아래와 같은 페이징 쿼리를 반복 실행
SELECT ... FROM my_table
ORDER BY id ASC
LIMIT 100 OFFSET 0 -- 1페이지

SELECT ... FROM my_table
ORDER BY id ASC
LIMIT 100 OFFSET 100 -- 2페이지

...
- 1페이지 읽는 중에, 누군가가 DB에서 데이터를 추가하거나 수정하거나 삭제한다면?
- OFFSET 기준은 정렬 기준이 없으면 흔들릴 수 있습니다 → 중복/누락 발생 가능
예시 상황:
- 1페이지 (id 1~100) 읽음
- 누군가 id=55의 데이터를 삭제
- 2페이지 (OFFSET 100) 읽을 때는 실제로는 id 101
200이 아니라 id 102201이 될 수도 있음
→ 한 건 누락됨
해결방안으로는 읽기 중에는 되도록 데이터 변경 피하기,
업데이트가 불가능한 키를 통해 정렬 (created_at)
OFFSET 대신 WHERE id > ? LIMIT 100 방식으로 처리 (PK 기반 키셋 페이징)
JdbcPagingItemReader은 주로 다음과 같은 상황에서 유리하다
병렬 처리/ 멀티 쓰레드 환경에서의 작업이 필요한 경우 or
대량 데이터를 일정 크기로 나눠서 안정적으로 처리하고 싶은 경우에 적합하다.
'Spring' 카테고리의 다른 글
| [Spring] IOC , DI (0) | 2025.04.02 |
|---|---|
| [Spring Batch] 대용량 데이터의 처리 (1) | 2025.04.01 |
| Spring Security (0) | 2025.02.24 |
| Component (0) | 2024.10.15 |
| 스프링 MVC란? (0) | 2024.10.14 |