회사에서 만든 MES 기반의 시스템이 있었다.
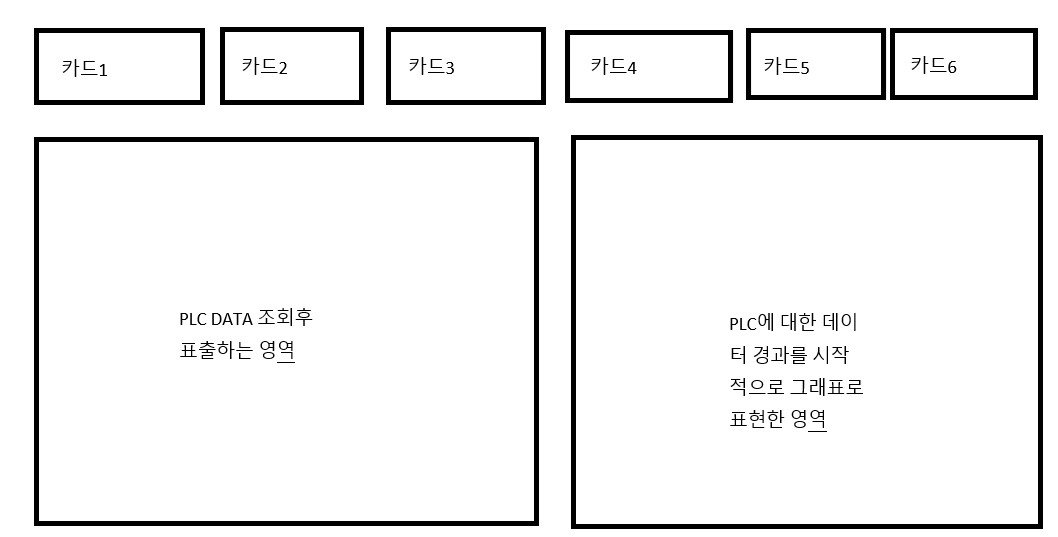
(회사에서 진행한 프로젝트라 실제 화면은 첨부하지 못함)
카드는 어떠한 테이블에서 정보 조회후 롤링형식으로 보여주는 영역이였고
PLC에서 발생한 데이터를 plc테이블에서 조회한 후 각 영역에 보여주는 영역 2개가있었는데
카드 영역에 비해서 PLC 표출영역이 너무 늦게 뜨는 것이다.
PLC 영역을 SSE을 사용하여 실시간으로 데이터변화를 보여주는 화면이라서 조회속도가 중요했다.
🔴 문제의 핵심원인
* 페이지 로드 후 카드영역은 1초후에 뜨는데 PLC영역은 거의 3~4초후에 뜸.
* 즉 데이터를 불러오는 시간이 너무 길다
* 해당 PLC데이터는 1분마다 insert되기에 Materialized View 사용은 적절하지 않았다.
해당 PLC관련 테이블은 아래와 같이 정의되었다.
| 발전소코드 (기본키1) (character) |
아이템번호 (기본키2) (character) |
날짜 (기본키3) (timestamp) |
PLC데이터항목 (기본키4) (character) |
수치 (일반컬럼) (numeric) |
항목번호 (일반컬럼) (character) |
| DG1 | 500 | 2025-03-10 | 유효전력 | 100.6 | 512 |
복합키형태인 테이블인데 해당 테이블에는 발전소코드가 거의 'DG1' 로 고정적으로 들어간 형태였다 ( 카디널리티 낮음)
하지만 추후에 다른 발전소가 추가될 수 있는 형태이다,
아이템번호 또한 '500' 으로 고정된 데이터 값이였다. (카디널리티 낮음)
그나마 고유성이 높은 컬럼이 날짜컬럼과 PLC데이터항목컬럼이였다.
그렇다면 기본키에 대한 인덱싱이 (발전소코드, 아이템번호, 날짜, PLC데이터항목 ) 이렇게 적용이 되는 것이다.
PLC의 데이터는 1분마다 각 항목이 순서대로 들어온다.
1분후 : 전력량 : x, 무효전력량 : y , 역률합 : x+y , 소모가스량 : z , 평균전압 : v, 온도: c, 가동시간 : h .....기타항목
2분후 : 전력량 : x2, 무효전력량 : y2 , 역률합 : x2+y2 , 소모가스량 : z2 , 평균전압 : v2, 온도: c2, 가동시간 : h2 ....기타항목
내가 보여줘야 할 항목은 전력량,무효전력량, 역률합, 소모가스량, 평균전압, 온도 , 가동시간 이었다.
각 항목의 가장 최신 값들을 가져오려는 의도였다. ( 다른 데이터도 많이 들어옴...30개항목은 들어온듯)
기존 쿼리는 아래와 같았다.
select 아이템명, 수치
				from plc500
				where PLC데이터항목 IN('전력량'
								, '무효전력량'
								, '역률합'
								, '소모가스량'
								, '평균전압'
								, '온도'
								, '가동시간')
				and 발전소코드 = 'DG1'
				order by 날짜 desc limit 7;
이러한 쿼리였는데 쿼리를 잘못짰다. 이 쿼리는 기본키인덱싱을 활용하지 못했다.
기본키는 발전소코드, 아이템번호, 날짜, 데이터항목 인데
조건절에서 기본키 인덱싱을 활용하지 못함 (순서도 잘못되고, 카디널리티를 고려하지 않은 인덱싱구조)
쿼리가 풀 인덱스 스캔에 가까운 동작하였다.
********** 나중에 안 사실이지만 조건절에서 인덱스 사용순서는 상관없다고 한다.
PostgreSQL 옵티마이저가 조건의 순서를 무시하고 최적화한다고 한다.
하지만 인덱스 생성할때의 순서는 중요하다 보통 카더널리티가 높은것을 우선으로 먼저 선언한다.
또한 IN절도 배열 기반 탐색으로 변환해서 상관없다고 한다 하지만 IN절에 들어가는 항목수가 매우많으면 영향o
하지만 기존 쿼리가 느린 이유는 IN절 때문이 맞다. 뭐여, 상관없다메?
그렇지만 동작방식이 이렇게 된다. 여러 개의 PLC데이터항목에 다해여 별도의 인덱스 범위 스캔 발생했는데
각 범위의 결과는 DESC 정렬이 되어있지만, 전체 결과는 섞여 있다 결국
모든 결과 합치고 ORDER BY indatem DESC 를 다시 정렬연산으로 처리하기 때문이다.
실행계획 결과는 아래와 같이 나왔다.
EXPLAIN (ANALYZE, BUFFERS)
select select 아이템명, 수치
				from 500PLC
				where PLC데이터항목 IN('전력량'
								, '무효전력량'
								, '역률합'
								, '소모가스량'
								, '평균전압'
								, '온도'
								, '가동시간')
				and 발전소코드 = 'DG1'
				order by 날짜 desc limit 7;

"Limit  (cost=6.22..6.22 rows=1 width=38) (actual time=17.875..17.876 rows=0 loops=1)"
"  Buffers: shared hit=1 read=2"
"  ->  Sort  (cost=6.22..6.22 rows=1 width=38) (actual time=17.874..17.874 rows=0 loops=1)"
"        Sort Key: 날짜 DESC"
"        Sort Method: quicksort  Memory: 25kB"
"        Buffers: shared hit=1 read=2"
"        ->  Index Scan using plc500_pkey on plc500  (cost=0.43..6.21 rows=1 width=38) (actual time=17.867..17.867 rows=0 loops=1)"
"              Index Cond: ((발전소코드)::text = 'DG01'::text)"
"              Filter: ((PLC데이터항목)::text = ANY ('{전력량,무효전력량,역률합,소모가스량,평균전압,온도,가동시간}'::text[]))"
"              Buffers: shared hit=1 read=2"
"Planning:"
"  Buffers: shared hit=5"
"Planning Time: 0.782 ms"
"Execution Time: 17.899 ms"
비록 인덱스가 조건 필터링엔 사용되었지만,
ORDER BY 날짜 DESC 를 만족하는 top 7을 찾기 위해 전체 결과를 정렬해야 했음.
그리고 이 정렬은 디스크에서 블록을 대량으로 읽는 작업을 동반.
IN (...) 조건이 있는 경우 PostgreSQL은 정렬까지 인덱스로 사용하지 못할 수 있음
🔴 문제에 대한 해결방안
여기서 가장 큰 문제는 IN 조건을 사용하여 기본키 인덱스를 적절히 사용을 못하고 있다.
그래서 인덱싱을 따로 생성해주기로 하였다.
CREATE INDEX plc500_데이터항목_발전소코드_날짜
ON plc500 (데이터항목, 발전소코드, 날짜 DESC);
인덱스 생성은 했지만 문제는 in 조건절 사용이다. 나는 여러 데이터항목을 조건으로 조회해야하는데
'=' 비교를 해야 완벽히 인덱싱을 활용할 수 있었다.
내가 생각한 해결방안
✔ 1.멀티쓰레드를 통해 단일값 조회를 여러번 실행
✔ 2.해당 데이터항목만을 담은 테이블을 따로 구축하여 그냥 거기서 조회
하지만 둘다 문제점이 명확했다.
1번 방안에 대한 문제점:
해당 문제는 일단 쓰레드 관리를 해줘야 한다는 거다. 개발자입장에서는 귀찮을 수 밖에 없다.
또한 여러번 select 요청을 DB에 날리기 때문에 오버헤드가 많이 발생한다. 되도록이면 한번의 쿼리로
커넥션을 최소화 하는게 중요했다.
2번 방안에 대한 문제점:
해당 문제는 해당 테이블에 대한 용량을 또다시 차지한다는 것이다. 안그래도 PLC데이터가 하루에 거의 14만개가 쌓인다.
근데 하나의 PLC데이터 테이블에만 14만개라는 것이다.
또 다른 항목의 PLC데이터들도 3개가 더있는데 거의 50만개가 넘는 데이터가 있다.
이것을 중복해서 또 다시 저장한 테이블을 만들기에는 용량이 비대해진다.
또한, 해당 테이블에 대한 insert 작업 또한 동반하기 때문에 I/O 많고 CPU 부담 큼 → 느림.
나는 다른방법을 찾아야했다. 기존테이블을 활용하면서 여러번의 DB 요청이 없는 방안이 무엇일까?
✅ 단일조회로 가져가자 그리고 그 조회결과를 모두 합치자 -> UNION ALL을 활용
해당 방안은 기존 테이블을 이용하면서 여러번의 쿼리가 날라가지 않는다.
바로 적용해보았다.
✔ 적용 쿼리
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '전력량' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub1
UNION ALL
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '무효전력량' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub2
UNION ALL
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '역률합' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub3
UNION ALL
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '소모가스량' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub4
UNION ALL
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '평균전압' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub5
UNION ALL
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '온도' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub6
UNION ALL
SELECT * FROM (
    SELECT 날짜, 데이터항목, 수치 FROM plc500
    WHERE PLC데이터항목 = '가동시간' AND 발전소코드 = 'DG1'
    ORDER BY 날짜 DESC
    LIMIT 1
) AS sub7
ORDER BY 날짜 DESC;
코드가 길어지지만 성능은 최적화 할 수 있어서 해당 쿼리로 갈려고 했다.
하지만 또 다른 생각이 들었다. 마지막에 굳이 날짜 정렬을 또 해야하나? 이미 서브쿼리에서 정렬을 하였는데..
그리고 애초에 순서는 중요치 않았다. 그래서 ORDER BY 날짜 DESC; 는 제거하였다.
성능테스트 결과 아래와 같다.
"Append  (cost=0.56..28.04 rows=7 width=50) (actual time=0.080..0.633 rows=7 loops=1)"
"  Buffers: shared hit=35"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.079..0.080 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.078..0.078 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '전력량'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.064..0.064 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500 plc500_1  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.063..0.063 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '무효전력량'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.072..0.072 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500 plc500_2  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.071..0.072 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '역률합'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.182..0.182 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500 plc500_3  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.181..0.181 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '소모가스량'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.085..0.085 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500 plc500_4  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.084..0.084 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '평균전압'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.075..0.075 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500 plc500_5  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.074..0.074 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '온도'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"  ->  Limit  (cost=0.56..3.99 rows=1 width=50) (actual time=0.068..0.068 rows=1 loops=1)"
"        Buffers: shared hit=5"
"        ->  Index Scan using INDEX plc500_데이터항목_발전소코드_날짜 on plc500 plc500_6  (cost=0.56..117459.99 rows=34188 width=50) (actual time=0.067..0.067 rows=1 loops=1)"
"              Index Cond: (((데이터항목)::text = '가동시간'::text) AND ((발전소코드)::text = 'DG1'::text))"
"              Buffers: shared hit=5"
"Planning:"
"  Buffers: shared hit=38"
"Planning Time: 3.833 ms"
"Execution Time: 0.749 ms"
각각 인덱스를 완벽히 타면서 최소한의 블록만 읽고, 결과를 합치는 방식으로 동작한 것같다.
✔ Index Scan 사용 모든 서브쿼리에서 'plc500_데이터항목_발전소코드_날짜' 인덱스를 정확히 활용
✔ LIMIT 1 최적화 각 쿼리가 LIMIT 1만 요청하므로 실제 단일 행만 가져오며 빠름
✔ Append 전략 PostgreSQL이 Merge Append가 아닌 단순 Append를 선택함 → 빠르게 합쳐짐
✔ Index Scan + LIMIT 1 구조 덕분에 정렬 오버헤드가 없음
성능면에서도 차이가 보인다.
수정하기전 :
Planning Time -> 0.782ms
Execution Time -> 17.899ms
수정후 :
Planning Time -> 3.833ms
Execution Time -> 0.749ms
* 계획시간은 수정전이 더 짧긴하다. 아무래도 쿼리가 간결하니깐 하지만 실제 실행시간은 후자가 압도적으로 빠르다.
여기서 더 최적화된 쿼리를 찾아서 계획시간도 줄인다면 더 좋아질것으로 사료된다.
| 항목 | 기존쿼리 | 수정쿼리 |
| 실행시간 | 17.9 ms | 0.74 ms |
| 인덱스활용 | 극히 일부만 사용 (거의 풀스캔) | 완전한 활용 |
| 정렬비용 | 전건에 대한 정렬이 필요하다. | 없다 |
| 유지보수성 | 단순쿼리 | 조금 복자합지만 명확하다 |
실제 어플리케이션에서도 측정시간 차이가 많이났다.
| 실행 횟수 | 기존코드 실행시간(ms) | 수정코드 실행시간(ms) | 성능 개선 비율 |
| 1 | 1826.9765 | 266.8221 | 85.4% 개선 |
| 2 | 1926.1859 | 270.9548 | 85.95 개선 |
| 3 | 1830.6774 | 250.7474 | 86.3% 개선 |
| 4 | 1753.5468 | 335.6289 | 80.8% 개선 |
| 5 | 2246.1567 | 250.8011 | 88.8% 개선 |
전체적인 성능이 많이 올라갔다.
또한 실제화면에서도 이제는 카드보다 PLC데이터 영역이 더 빨리 조회된다.
이번에 인덱싱을 적용하는 과정에서 비약적인 성능차이를 경험했다. 인덱스에 대한 중요성을 좀 알 것 같다.
🔴 추후 개선방안
✔ 물리적으로 데이터량이 적다면 조회도 빠를것 -> SpringBatch를 활용하여 불필요한 데이터 제거
20250626 : 해당 사항 적용완료 . batch작업으로 새벽3시에 삭제함
✔ JSON 형태로 한꺼번에 묶어서 응답 -> 클라이언트 측에서 파싱이 편할것
20250626 : 이건 지금와서 보니깐 무슨소리인지 모르겠다 이미 한번에 응답을 할텐데...?
✔ 샤딩을 통한 테이블을 분리하면 좋을것같지만 테이블 단위 구조변경은 논의가 필요하다. 독단적x
20250626 : 부장님이 하지말라고 하셨다. 대신 배치작업으로 그냥 삭제하라고 하심.